이상 탐지
Table of contents
이상 징후 탐지
임계치 알림은 사용자가 수치를 입력했지만, 이상탐지는 AI가 자동으로 정상범위를 계산합니다.
Kubernetes Pod, Node 컨테이너에서 수집된 로그 및 메트릭 데이터를 실시간으로 분석합니다.
시스템 및 애플리케이션의 CPU, Memory, 네트워크 사용량, I/O 대기시간 등의 데이터를 통해 이상 상태를 감지합니다.
메뉴이동
클러스터 설정 ➡ 클러스터 환경설정 ➡ 알림 ➡ 이상탐지 알림
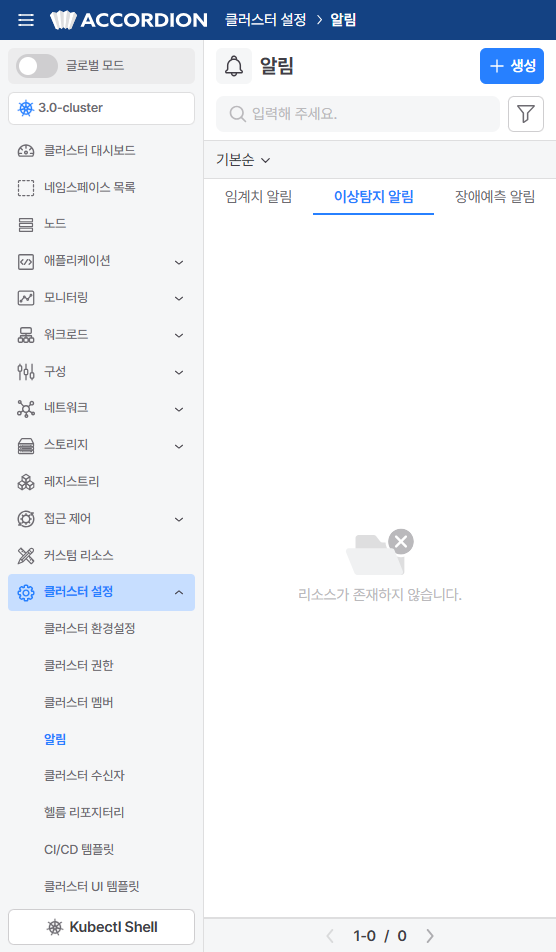
이상탐지 알림 생성
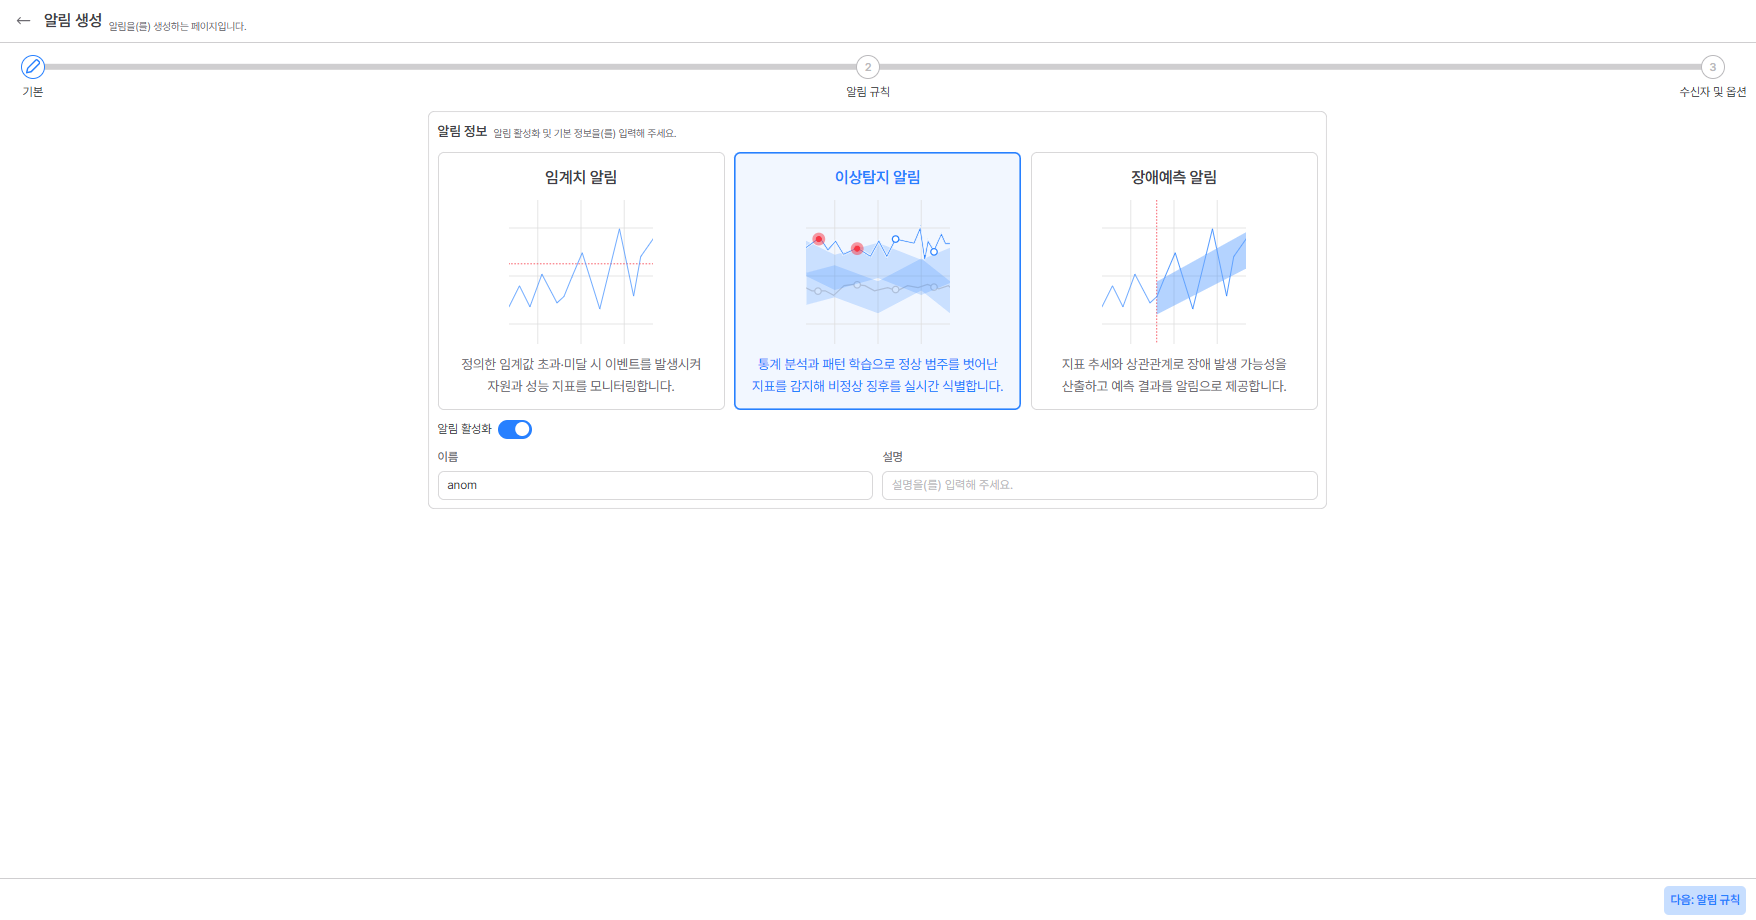
알림 탭의 이상탐지 알림 ‘생성’ 버튼을 이용하여 등록합니다.
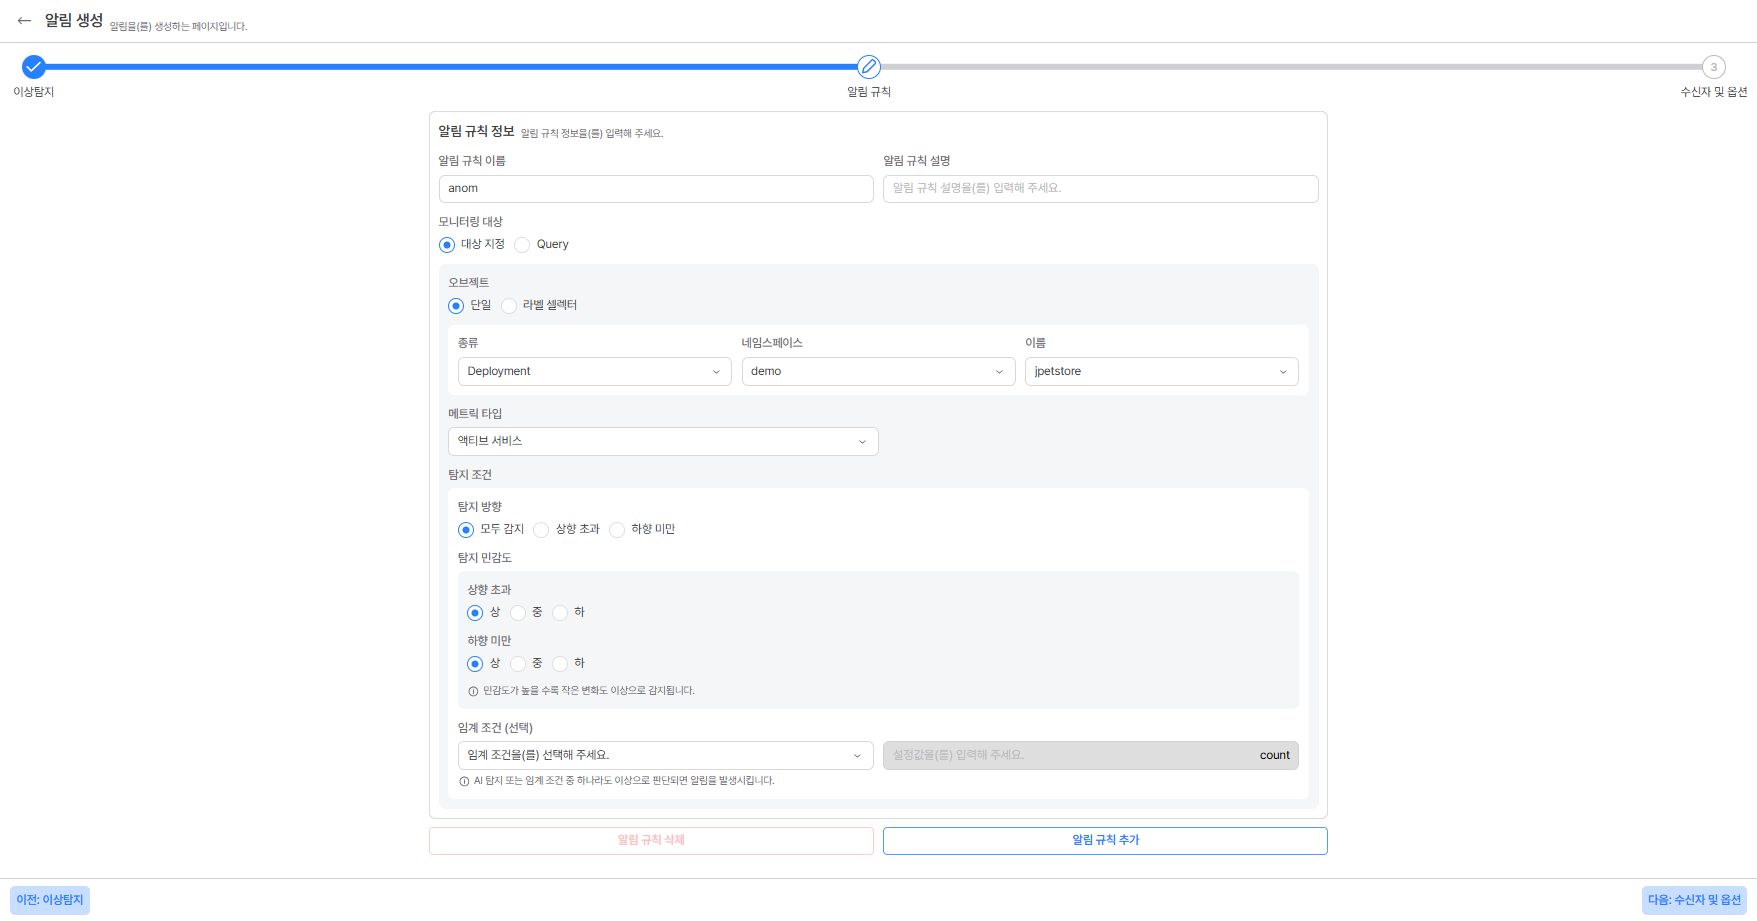
탐지 조건
| 모드 | 설명 |
|---|---|
| 탐지 방향 | 이상탐지 및 장애예측에 대해서 탐지할 방향 |
| 탐지 민감도 | 상, 중, 하 중 선택하며, 민감도가 높을수록 정상 범위의 경계가 좁아져 작은 변화도 이상으로 감지합니다. |
| 임계 조건(선택) | 알고리즘과 임계 조건을 함께 적용하여, 두 조건 모두 이상치로 판단될 경우에만 이상치로 감지합니다. |
상세 옵션
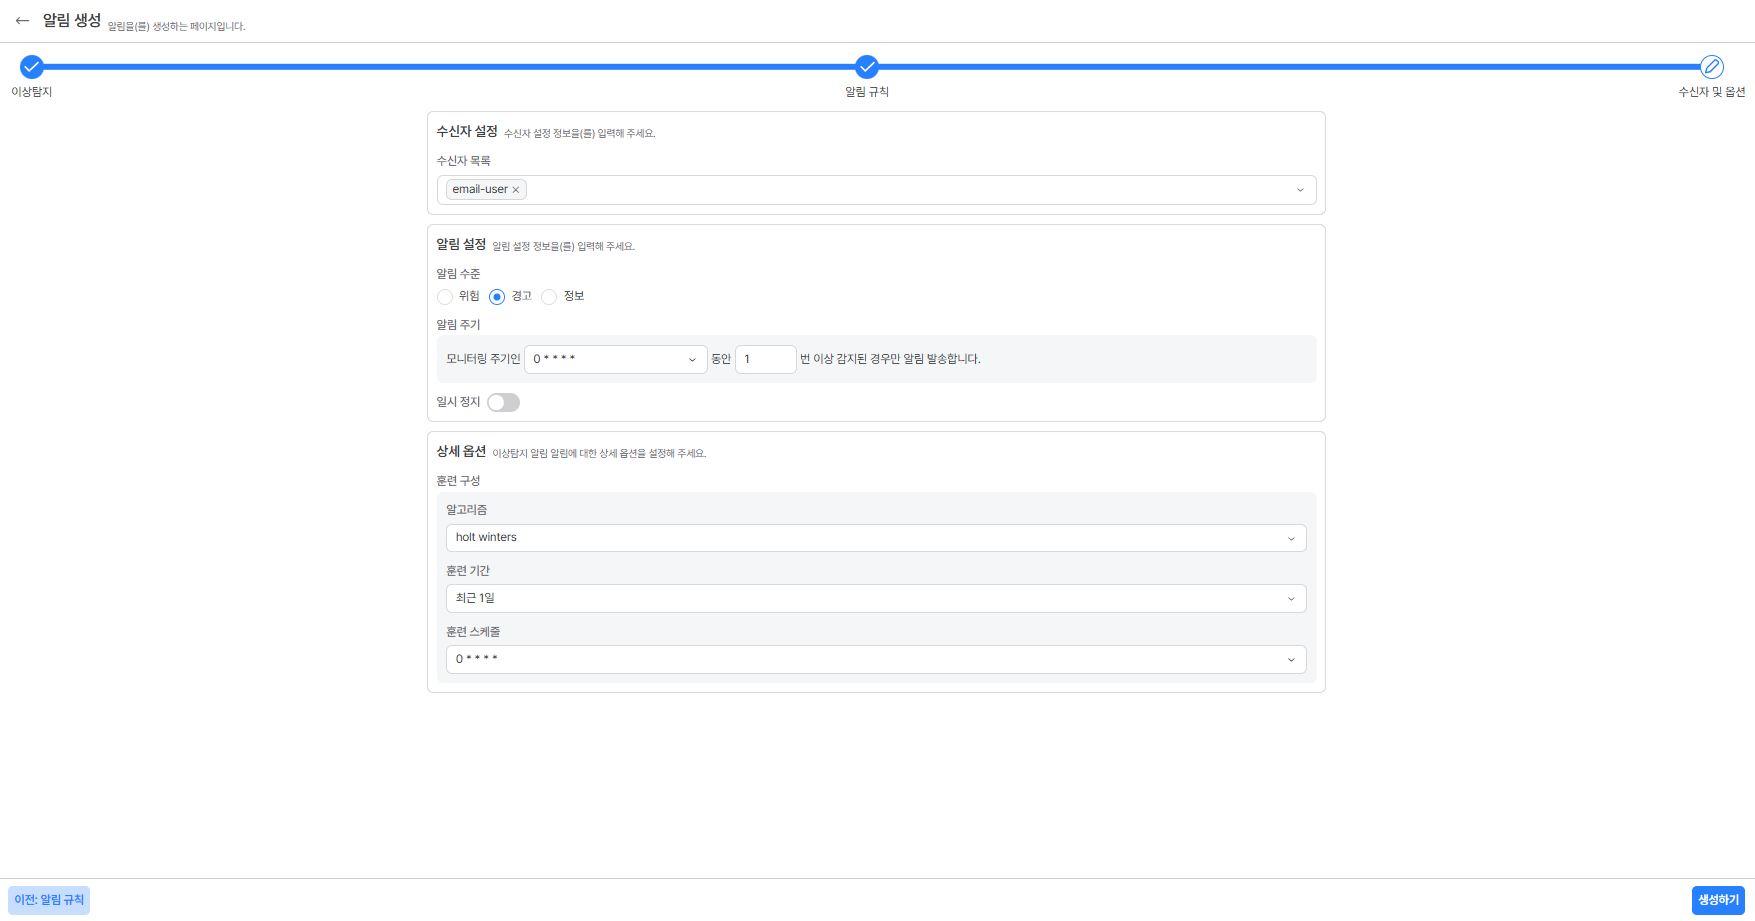
시스템의 데이터 패턴은 서비스 특성에 따라 다양하게 나타납니다. 각 알고리즘의 동작 원리와 적합한 활용 사례를 파악하여 최적의 탐지 모델을 구성할 수 있습니다. 알고리즘은 아래와 같습니다.
| 모드 | 설명 |
|---|---|
| holt winters | 데이터의 추세와 계절성(반복 주기)을 동시에 분석하여 주기적 패턴을 가진 지표의 이상징후를 탐지. |
| isolation forest | 전체 데이터 분포에서 비정상적으로 고립된 수치를 분리하여 산발적으로 발생하는 이상징후를 식별. |
| oneclass svm | 정상 데이터의 경계 영역을 학습하고 이를 벗어나는 예측 불가능한 이상징후을 감시. |
| moving average | 일정 기간의 평균치 대비 변동 폭을 분석하여 단기적인 급격한 지표 변화를 즉각 탐지. |
| sgd classifier | 학습된 정상/이상 상태의 특징값을 기반으로 유입되는 데이터를 실시간으로 신속히 분류. |
| prophet | 휴일이나 복합적 계절성 등 다양한 변수를 자동으로 반영하여 시계열 데이터의 장기적 흐름을 예측. |
| 항목 | 설명 |
|---|---|
| 훈련 기간 | 모델이 학습에 사용하는 과거 데이터 범위를 설정합니다. 최근 N일 또는 사용자 지정 중 선택할 수 있습니다. 최소 60분 이상의 데이터가 필요하며, 데이터가 부족한 경우 훈련이 수행되지 않습니다. |
| 훈련 스케줄 | 모델을 자동으로 재학습하는 주기 및 스케줄을 Cron 형태로 설정합니다. |
이상탐지 알림 조회
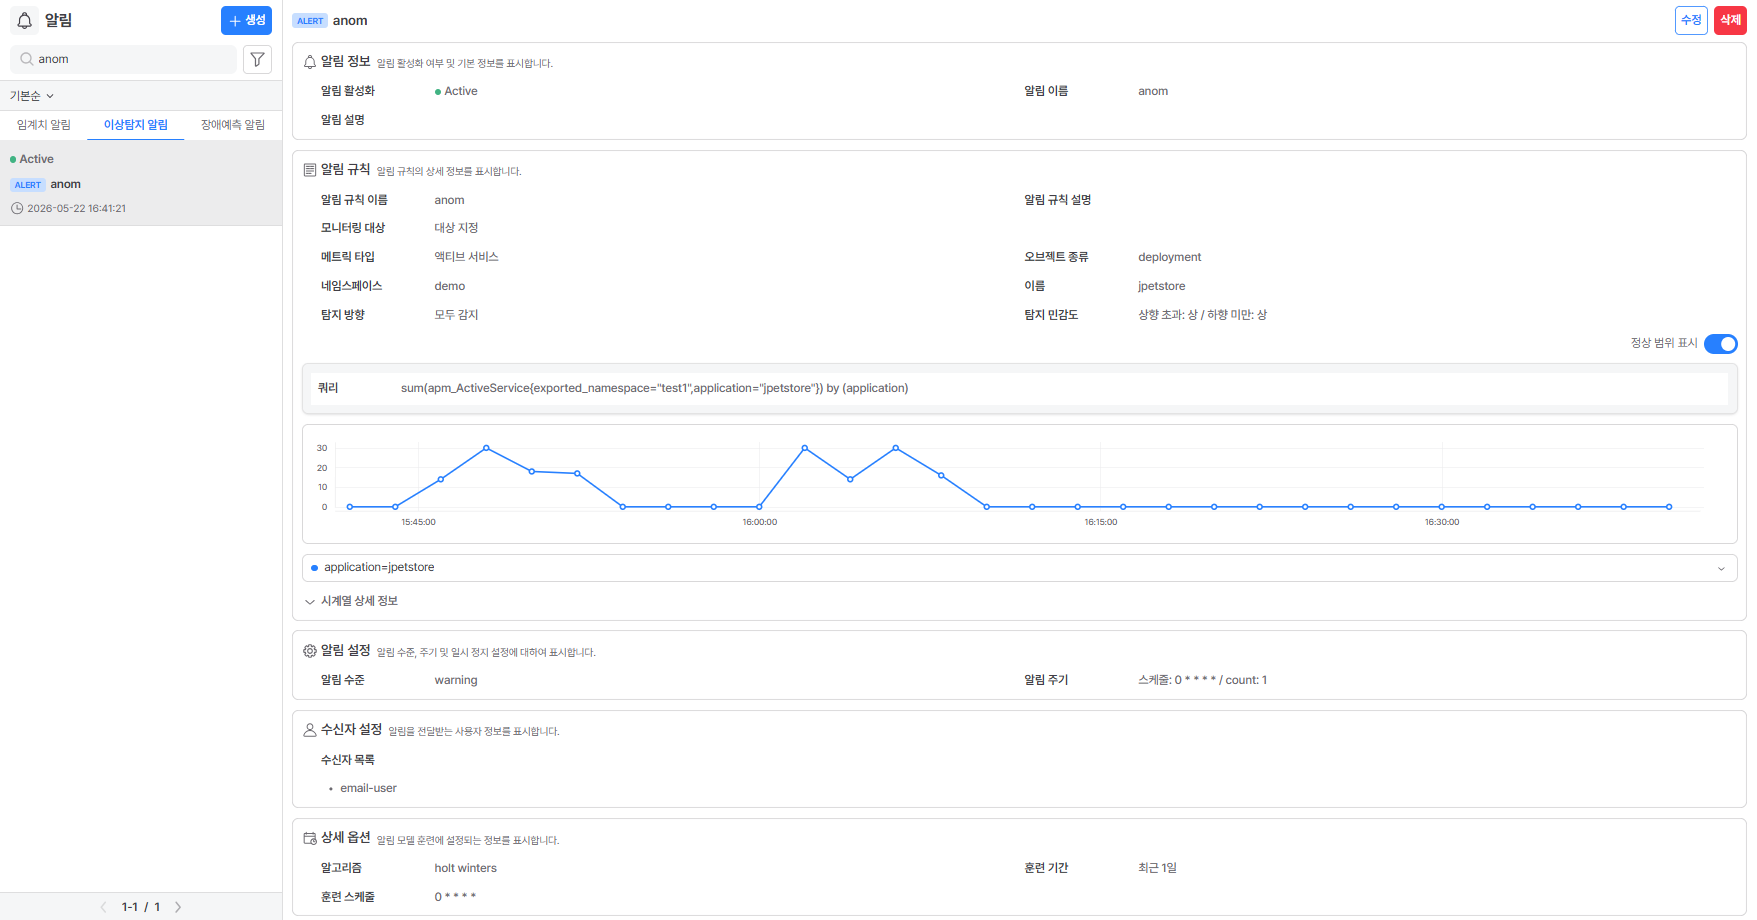
알람을 생성하면 좌측 목록에서 바로 확인할 수 있으며, 필터를 통해 원하는 항목만 골라볼 수 있습니다.
이상탐지 알림 수정
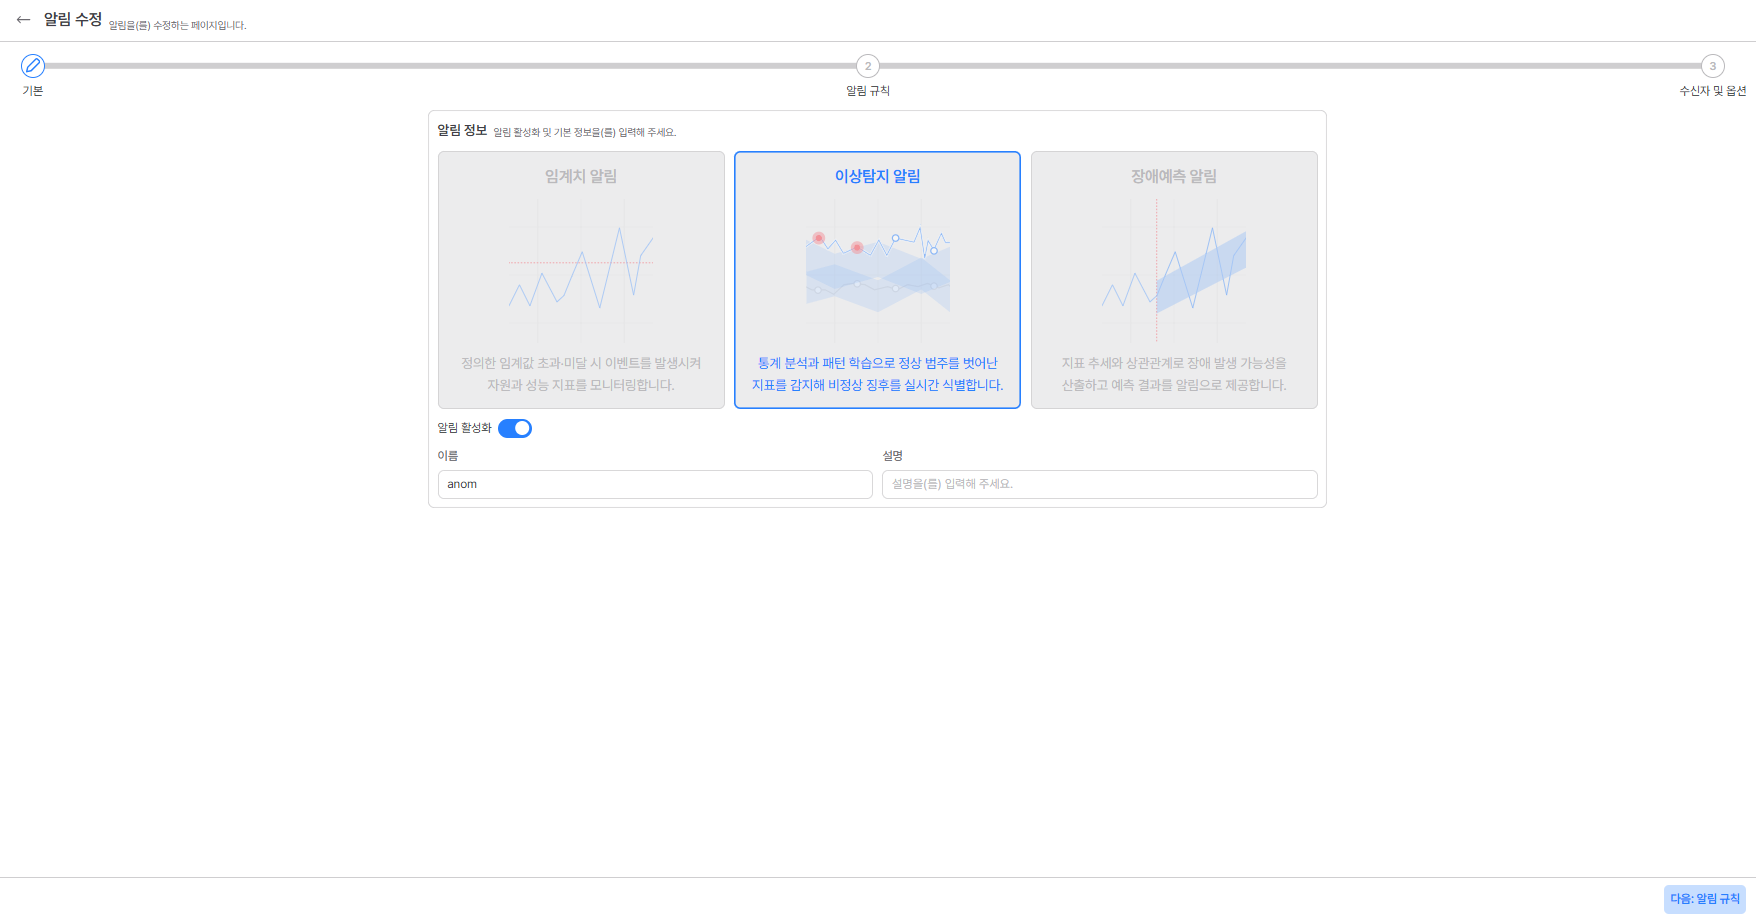
이상탐지 알림 목록에서 수정 버튼을 클릭하면 수정 화면으로 이동합니다. 수정 화면은 생성 화면과 동일한 구조이며, 기존에 입력된 정보가 표시됩니다.
이상탐지 알림 삭제
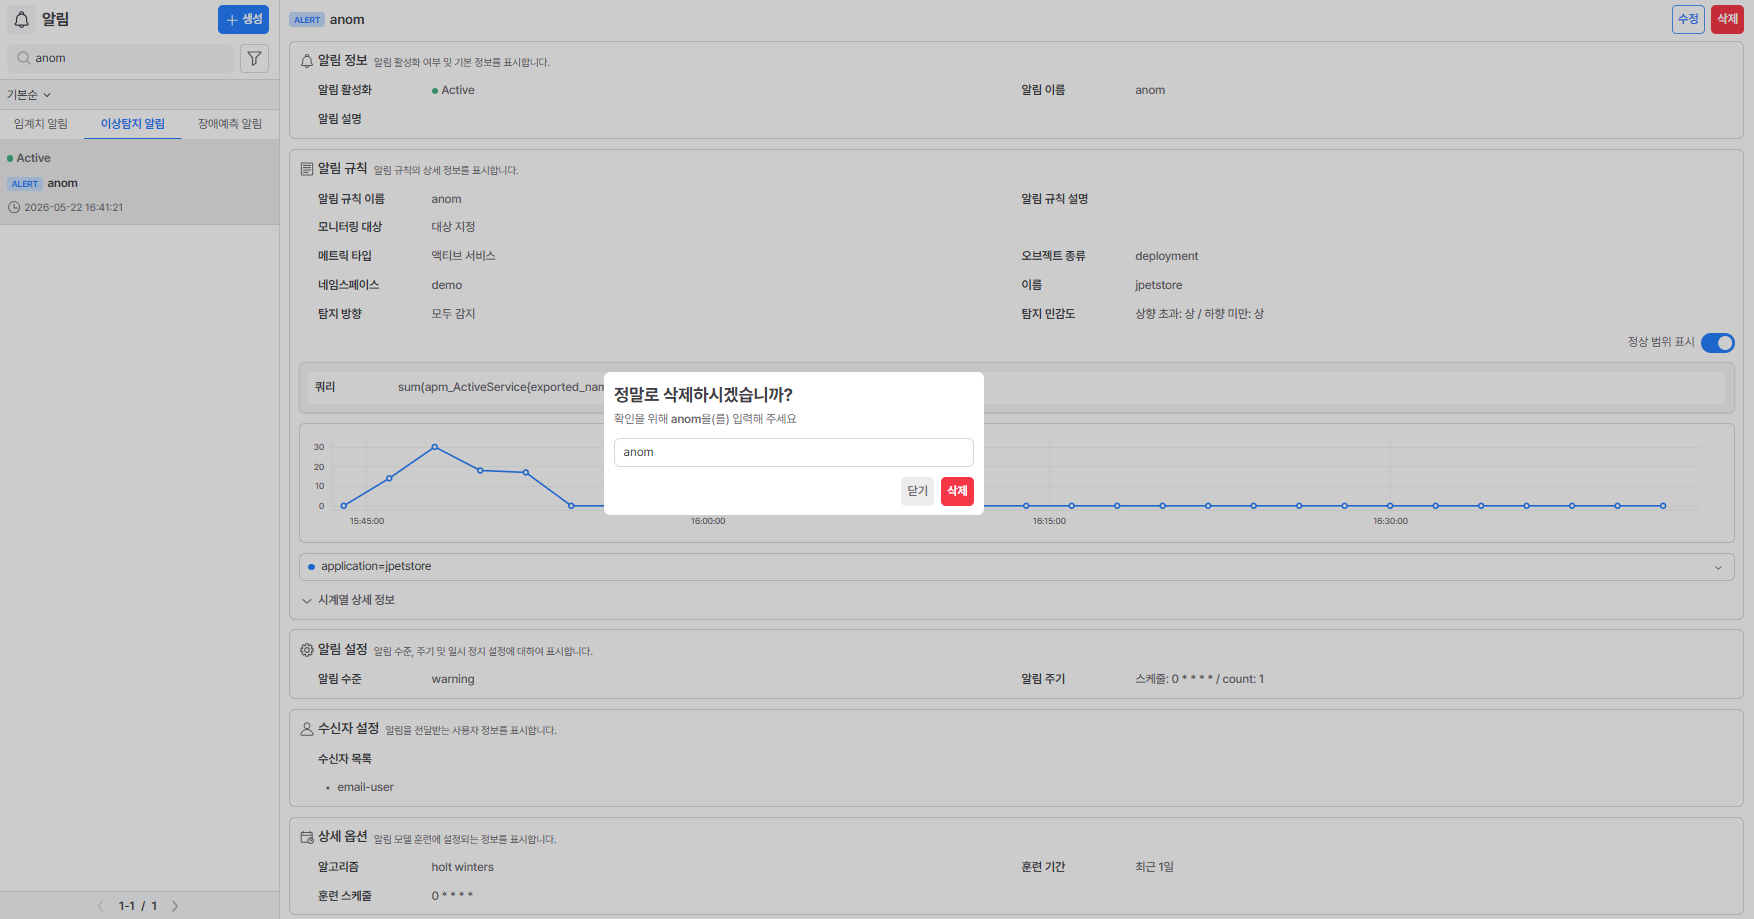
이상탐지 알림 목록에서 삭제 버튼을 클릭하면 해당 확장 기능이 삭제됩니다.
이상탐지 알림 시나리오
이상탐지 알림이 정상적으로 발생하는지 확인하기 위해 테스트 대상 애플리케이션의 ActiveService 값을 기준으로 알림 정책을 생성한다.
ActiveService는 현재 처리 중인 서비스 요청 수를 의미한다. 평상시에는 값이 0으로 수집될 수 있으므로, 본 예제에서는 Query 방식을 사용하여 최소값을 1로 보정한다.
clamp_min(sum(apm_ActiveService{exported_namespace="test1",application="jpetstore"}) by (application), 1)
위 쿼리는 test1 네임스페이스의 jpetstore 애플리케이션에 대한 ActiveService 값을 조회한다. 값이 0인 경우에는 1로 보정하고, 부하 발생 시 증가한 값은 그대로 사용한다.
1. 알림 생성
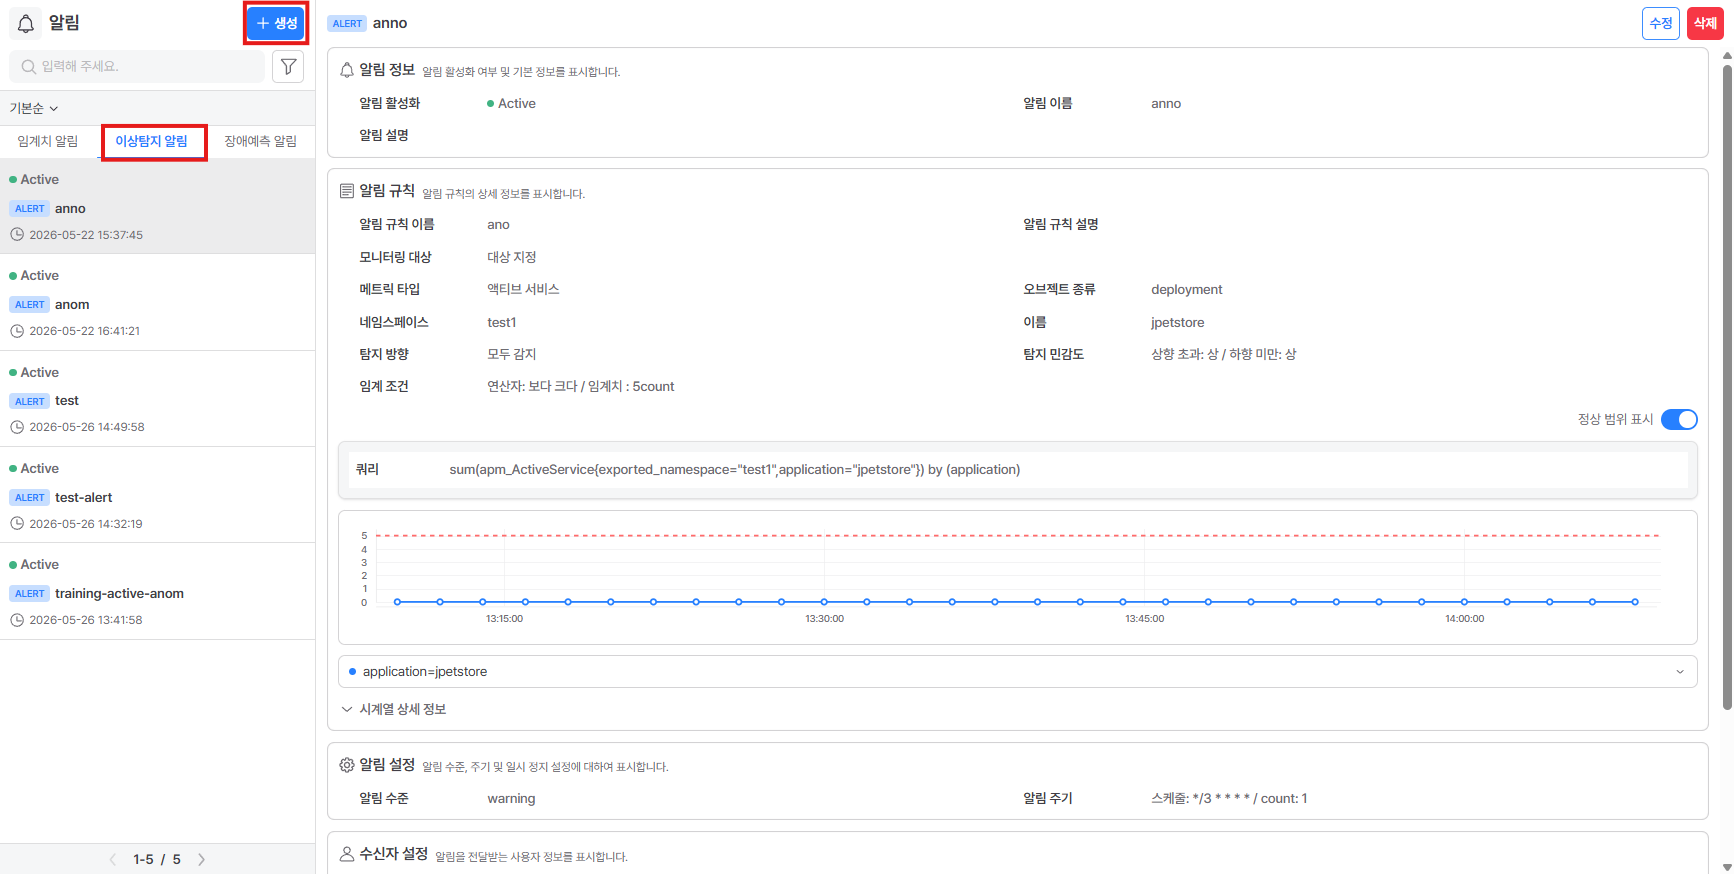
2. 이상탐지 알림 생성
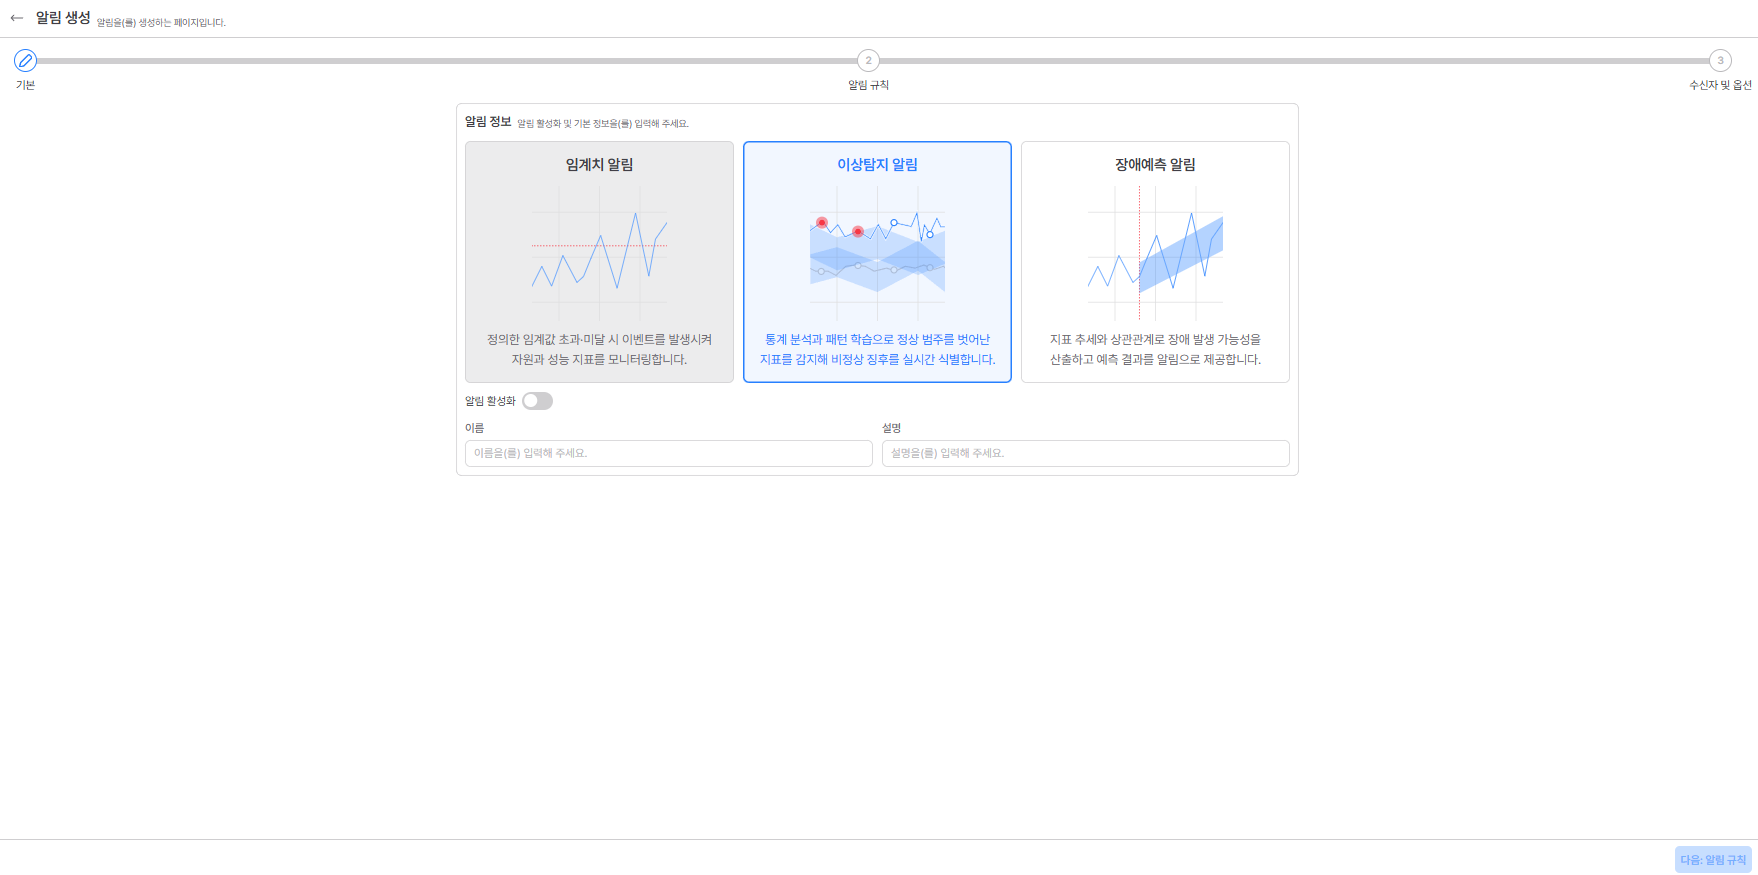
폼에 맞게 작성해주면 된다.
알림 활성화클릭이름설명
3. 알림 규칙 생성
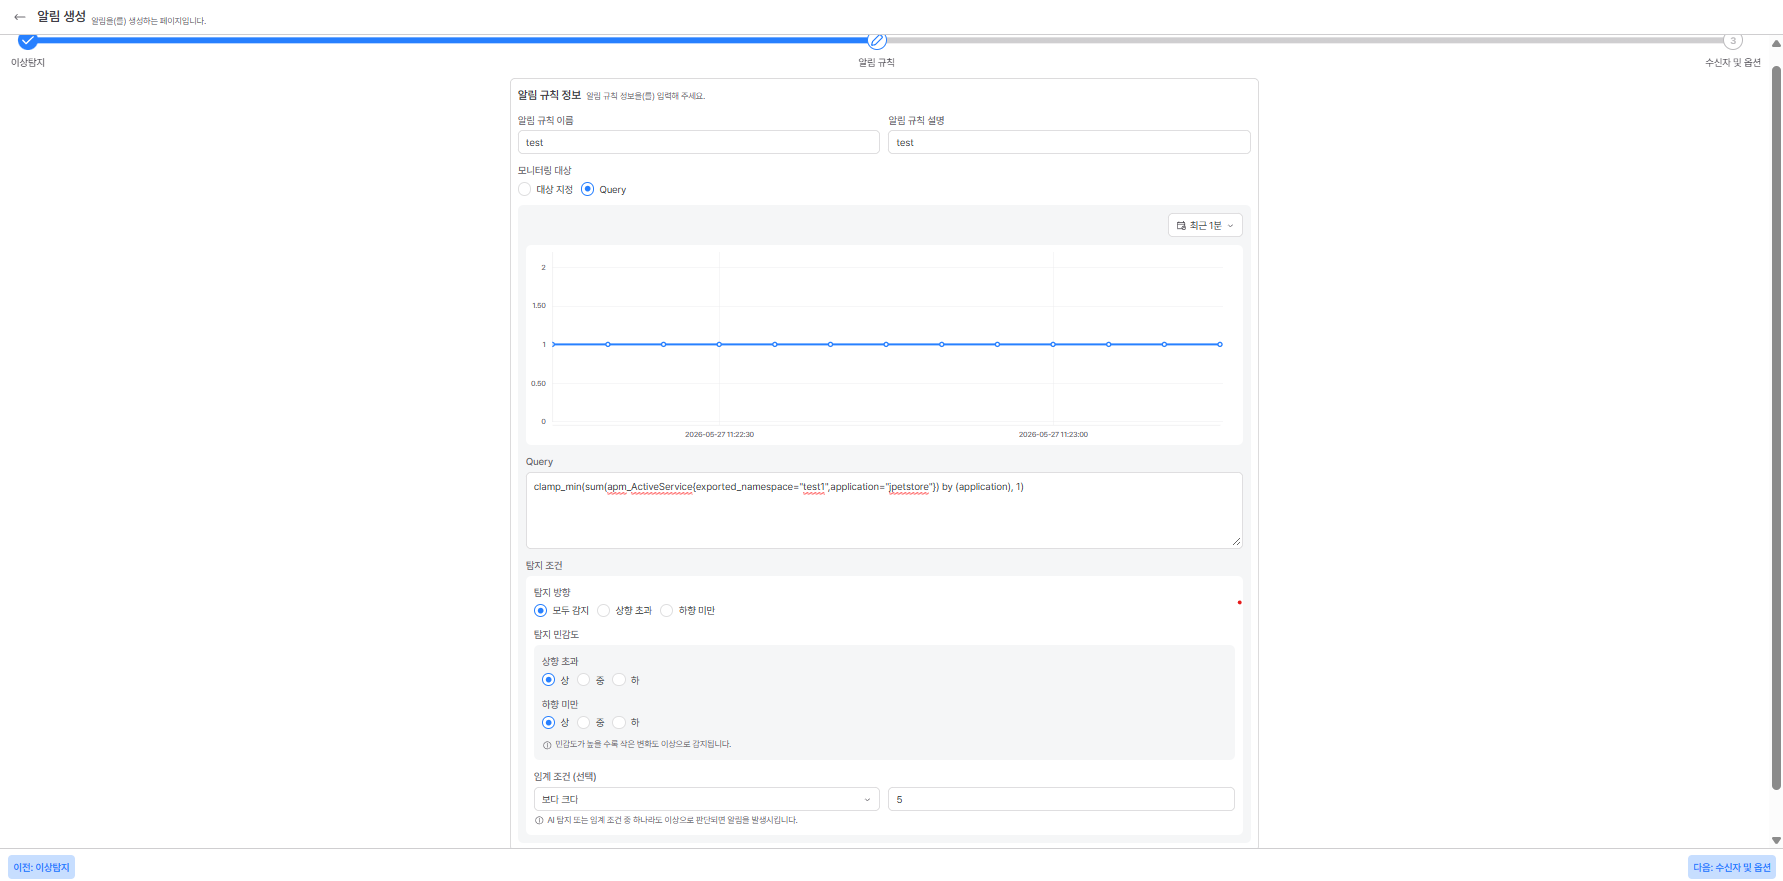
알림 규칙 이름알림 규칙 설명Query 선택- 아래 쿼리를 입력한다.
clamp_min(sum(apm_ActiveService{exported_namespace="test1",application="jpetstore"}) by (application), 1)
탐지 방향- 모두 감지탐지 민감도- 상향 초과 - 상
- 하향 미만 - 상
임계 조건- 보다 크다 / 5
4. 수신자 및 옵션
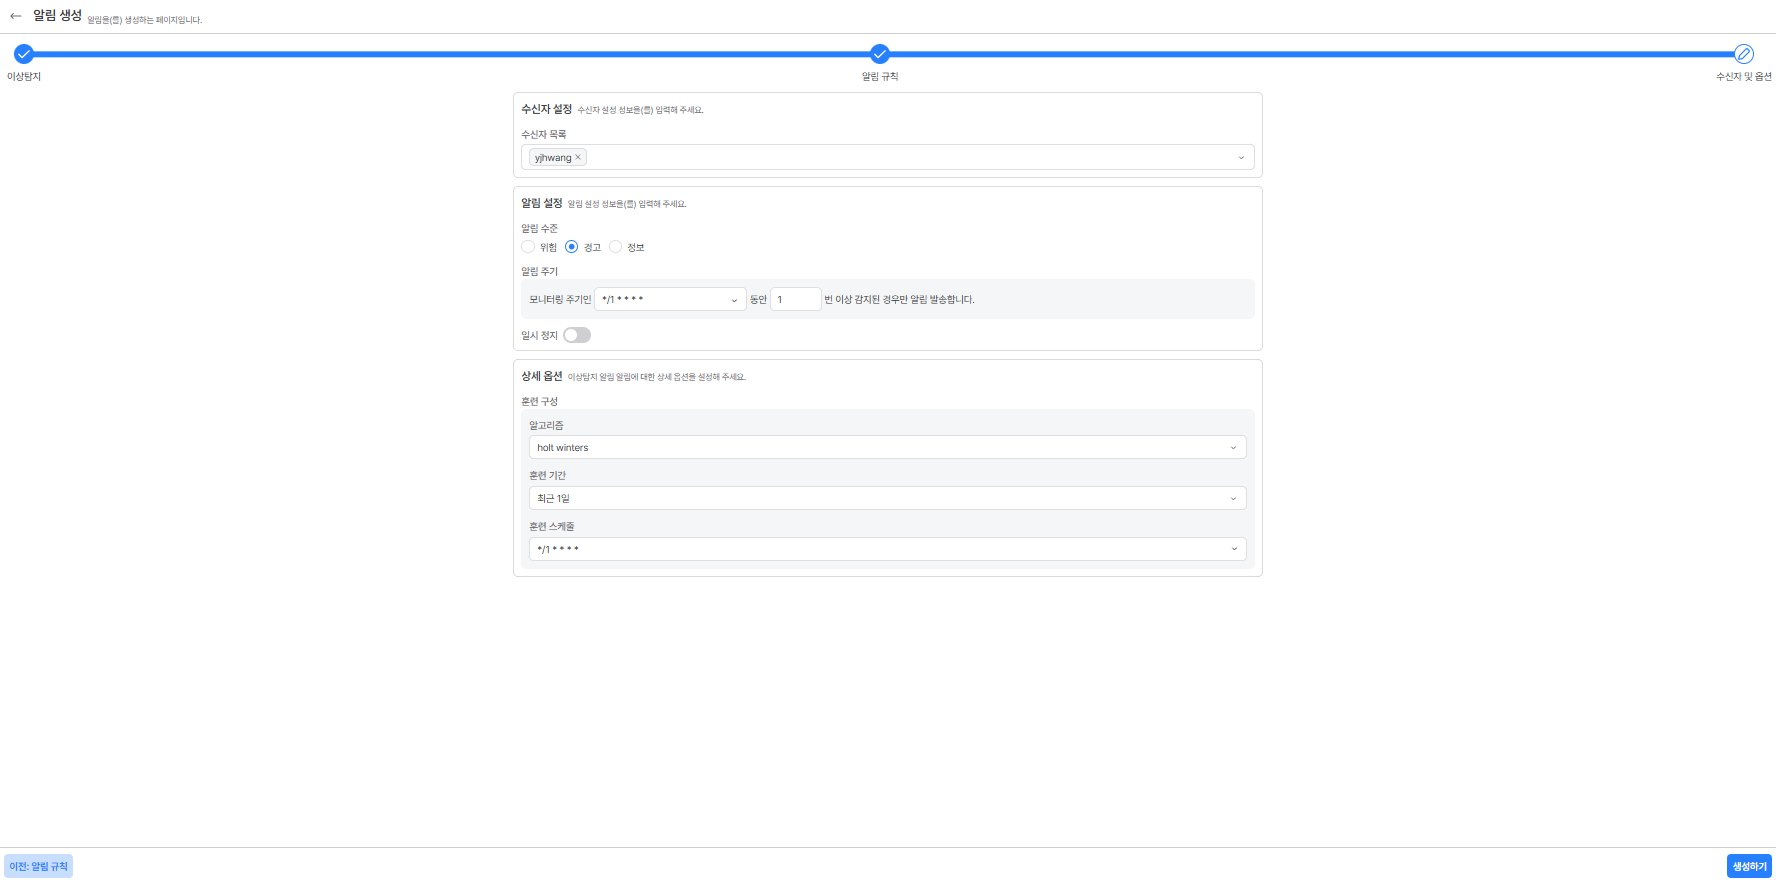
수신자 목록- 사전에 생성해둔 수신자 선택알림 수준- 경고모니터링 주기-*/1 * * * *알림 주기- 1알고리즘- Holt-Winters훈련기간- 최근 1일훈련 스케줄-*/1 * * * *
이후 생성하기 버튼을 클릭한다.
5. 부하 발생
알림 정책 생성 후 학습이 완료되면, 테스트용 부하 생성 Deployment를 생성한다.
본 예제에서는 jpetstore의 delay.jsp로 다수의 동시 요청을 보내 ActiveService 값을 증가시킨다.
다음 명령어로 부하 테스트 Deployment를 생성한다.
부하 테스트 YAML
apiVersion: apps/v1
kind: Deployment
metadata:
  name: jpetstore-thread-bomb
  namespace: test1
spec:
  replicas: 0
  selector:
    matchLabels:
      app: jpetstore-thread-bomb
  template:
    metadata:
      labels:
        app: jpetstore-thread-bomb
    spec:
      containers:
      - name: thread-bomb
        image: curlimages/curl:8.10.1
        command:
        - /bin/sh
        - -c
        - |
          echo "Thread Bomb Started. Target: http://jpetstore.test1:8080/delay.jsp"
          while true; do
            echo "[$(date)] Firing 30 requests..."
            i=1
            while [ $i -le 30 ]; do
              curl -s -o /dev/null -w "request $i: HTTP %{http_code}\n" --max-time 15 http://jpetstore.test1:8080/delay.jsp &
              i=$((i+1))
            done
            wait
            sleep 5
          done
위 Deployment 생성 후, 테스트 시점에 Pod를 실행한다.
kubectl scale deploy -n test1 jpetstore-thread-bomb --replicas=1
Pod가 정상적으로 실행되었는지 확인한다.
kubectl get deploy,pod -n test1 | grep thread-bomb

jpetstore-thread-bomb은 delay.jsp에 30개의 동시 요청을 반복적으로 전송한다. 요청이 일정 시간 지연되면서 처리 중인 요청 수가 증가하고, 이에 따라 ActiveService 값이 임계값 이상으로 상승한다.
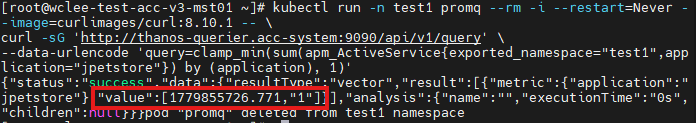
6. ActiveService 값 확인
다음 명령어로 ActiveService 값이 임계값보다 크게 증가했는지 확인한다.
kubectl run -n test1 promq --rm -i --restart=Never --image=curlimages/curl:8.10.1 -- \
curl -sG 'http://thanos-querier.acc-system:9090/api/v1/query' \
--data-urlencode 'query=clamp_min(sum(apm_ActiveService{exported_namespace="test1",application="jpetstore"}) by (application), 1)'
결과의 마지막 값이 5보다 크면 이상탐지 알림 조건을 만족한다.
7. 이상탐지 알림 확인
모니터링 주기가 지난 뒤 알림이 정상적으로 생성되면, 설정한 수신자에게 알림 메일이 발송된다.
수신자 메일함에서 이상탐지 알림 메일이 도착했는지 확인한다.
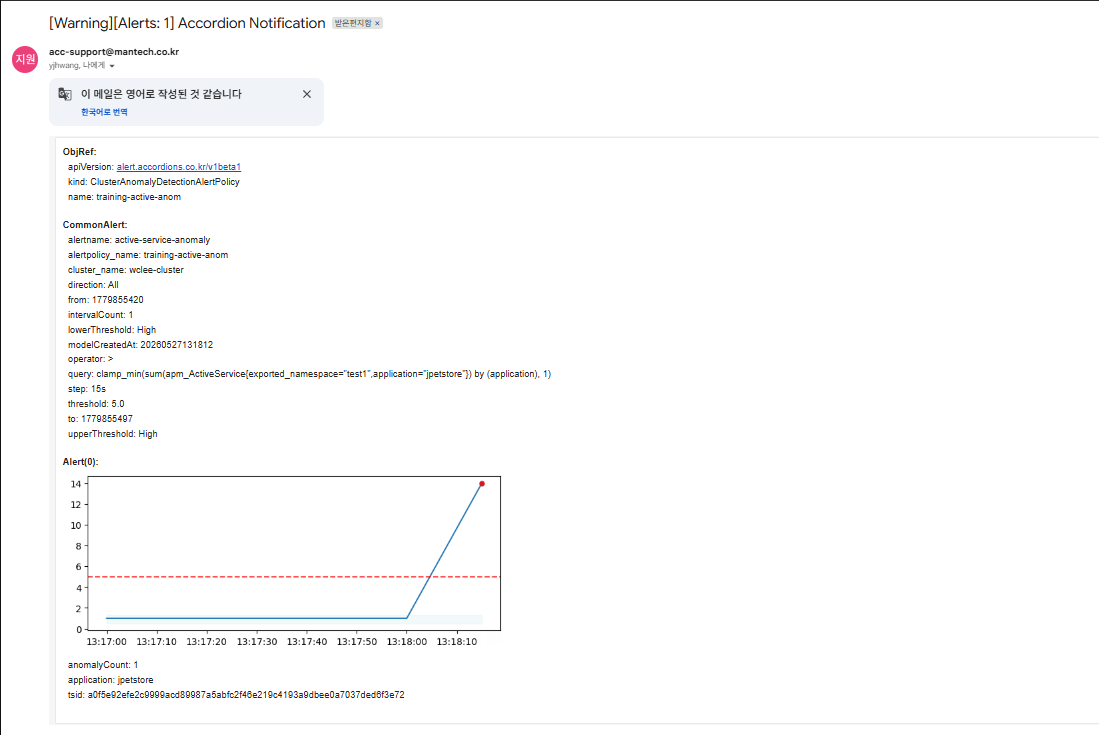
또는 콘솔의 모니터링 > 알림 로그 메뉴에서 생성된 알림 이력을 확인할 수 있다.
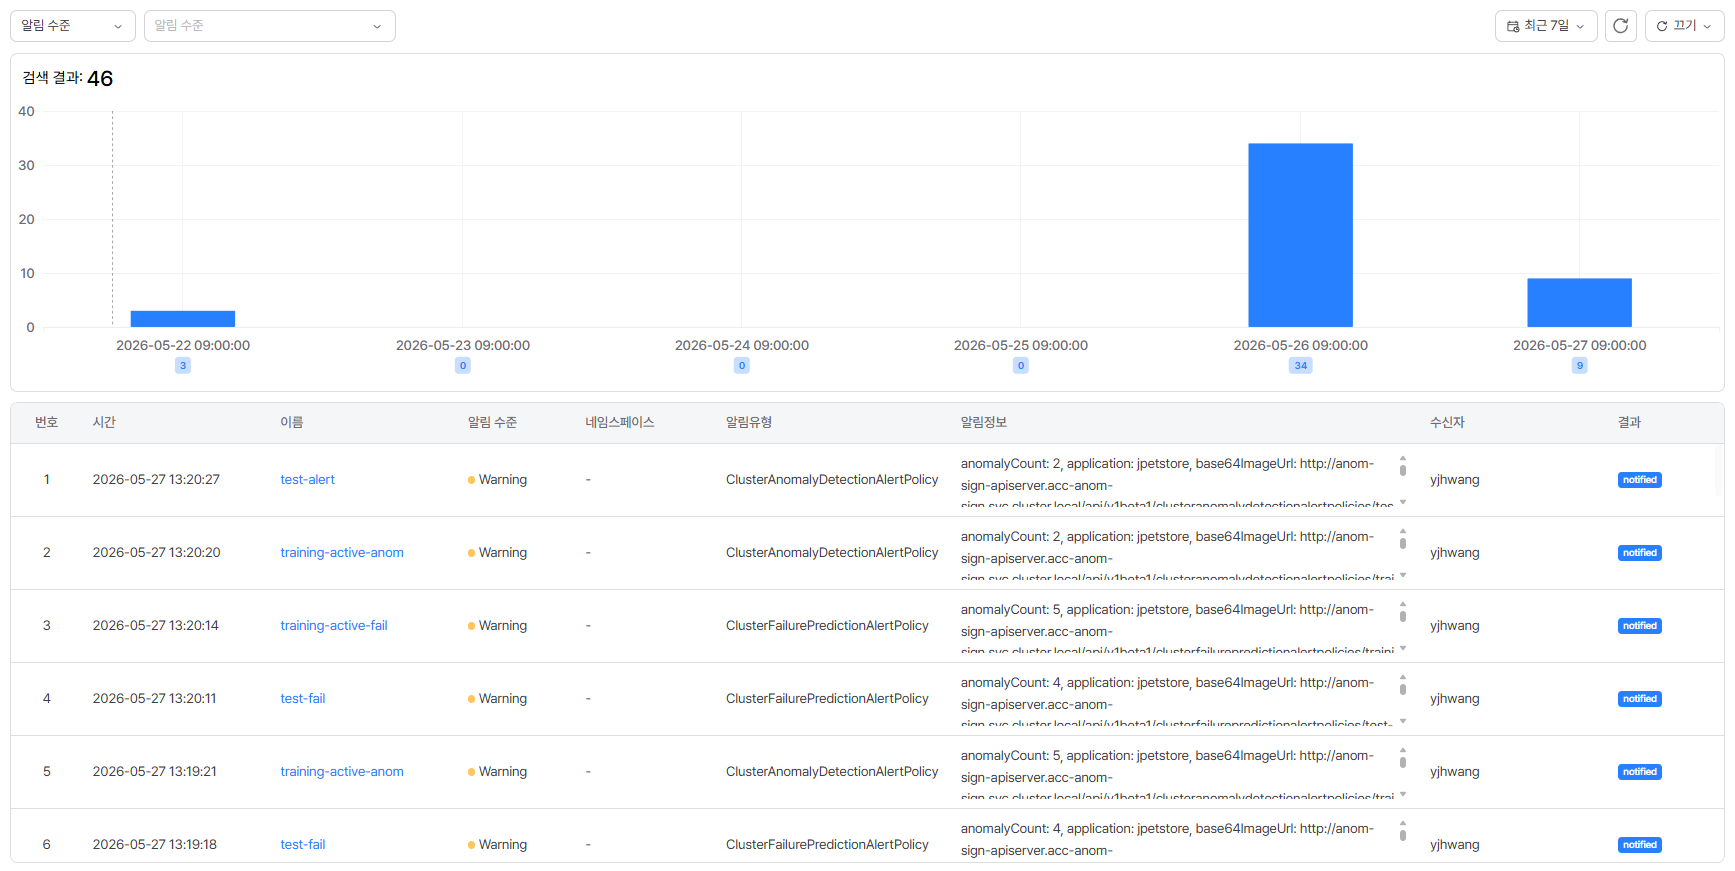
테스트 이후 부하 발생 시키던 pod는 scale down 하여 부하 테스트를 종료한다.
kubectl scale deploy -n test1 jpetstore-thread-bomb --replicas=0