알림 정책
Table of contents
알림 정책
알림은 시스템 성능에 대한 알림의 기준을 설정한다. 사용자가 정한 알림의 기준을 벗어나는 상황이 발생하게 되는경우 사용자가 빠르게 대처할 수 있도록 알림을 발송한다. 클러스터 스코프의 알림에서는 노드와 워크로드에 관련된 알림을 설정할 수 있고 네임스페이스 스코프의 알림에서는 워크로드에 관련된 알림을 설정할 수 있다.
💡 참고 : 알림 정책의 기준은 사용자가 임의로 정의하여 설정할 수 있습니다.
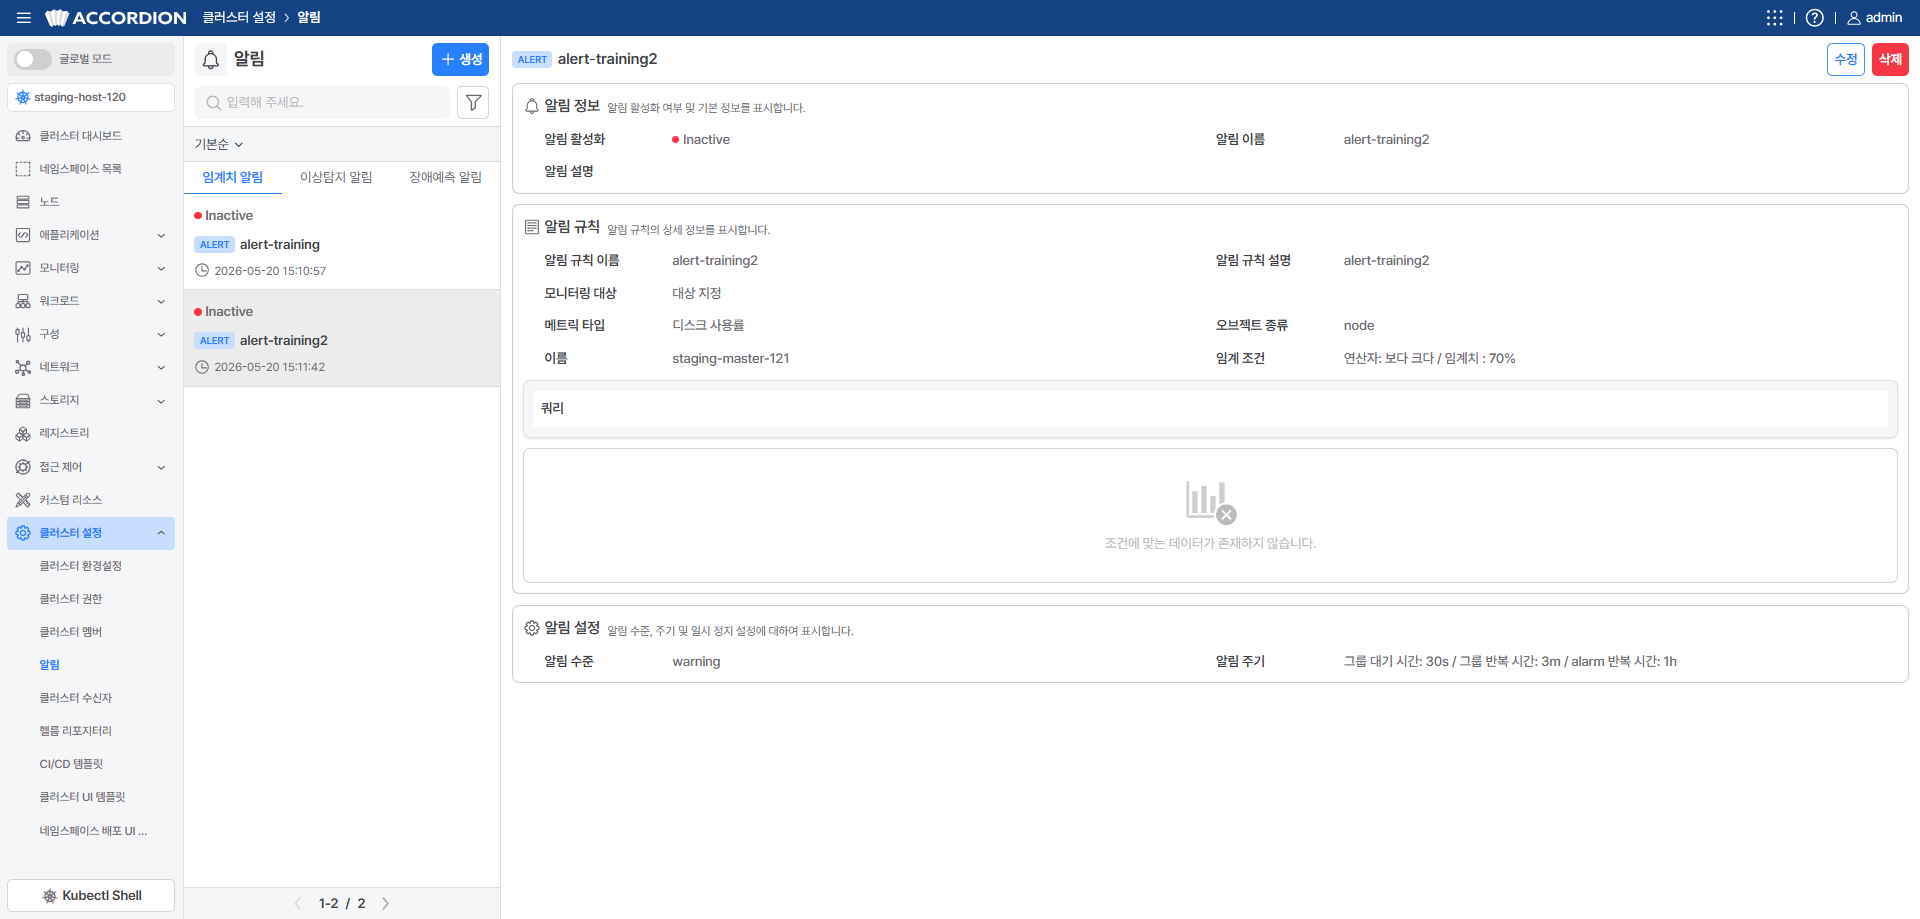
알림 생성
+ 생성 버튼을 선택하면 알림을 설정할 수 있는 폼이 나타난다. 폼에서 설정 정보를 입력하고 우측 하단 생성하기 버튼을 선택하면 알림이 생성된다. 하나의 알림은 다수의 알림 규칙들을 가질 수 있으며 각 규칙은 다른 알림 대상, 알림 수준, 알림 주기, 일시 정지 등을 설정할 수 있다.
알림 정보 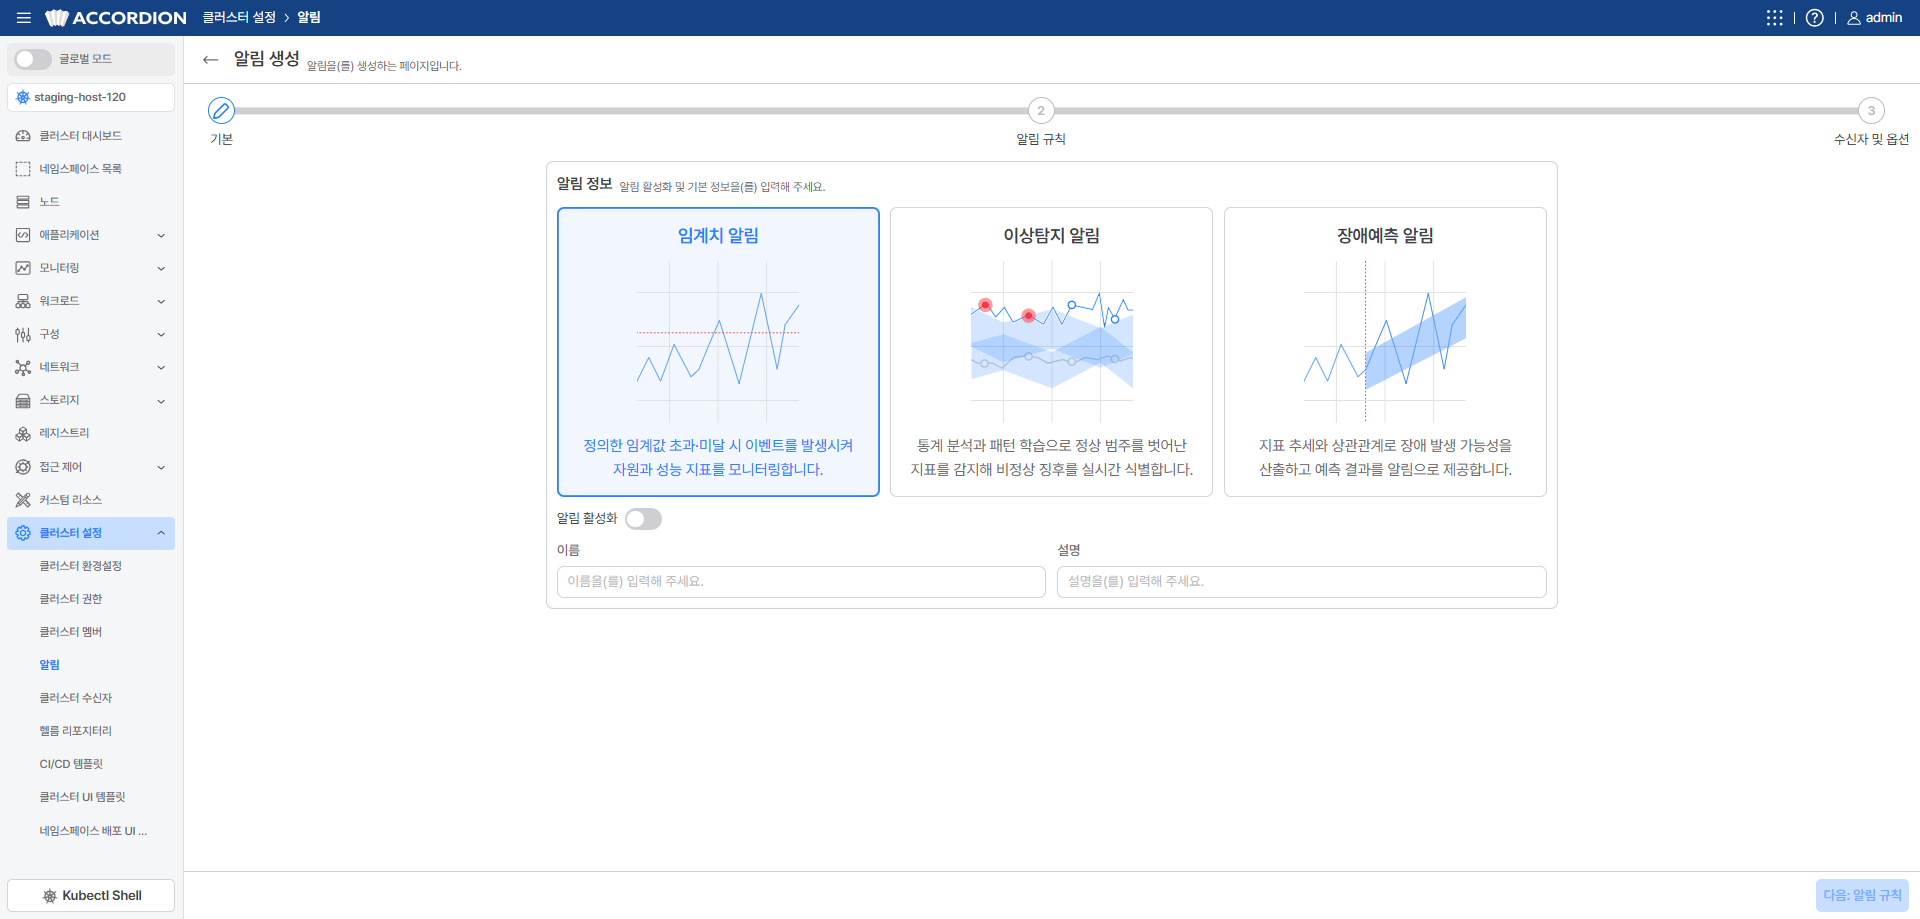
알림 정보(표)
| 항목 | 설명 |
|---|---|
| 알림 종류 | 폼에서 생성할 알림 종류를 선택할 수 있다. • 임계치 알림: 정의한 임계값 초과·미달 시 이벤트를 발생시켜 자원과 성능 지표를 모니터링 • 이상탐지 알림: 통계 분석과 패턴 학습으로 정상 범주를 벗어난 지표를 감지해 비정상 징후를 실시간 식별 • 장애예측 알림: 지표 추세와 상관관계로 장애 발생 가능성을 산출하고 예측 결과를 알림으로 제공 |
| 알림 활성화 | 알림 활성화 여부 |
| 이름 | 알림 이름 |
| 설명 | 알림에 대한 설명 |
알림 규칙 정보
- 알림 규칙명 : 알림 규칙 이름
- 알림 규칙 설명 : 알림 규칙에 대한 설명
- 타입 : 클러스터 알림 규칙은
Node, Node Selector, Expression3가지 타입의 알림 규칙을 설정 할 수 있습니다.
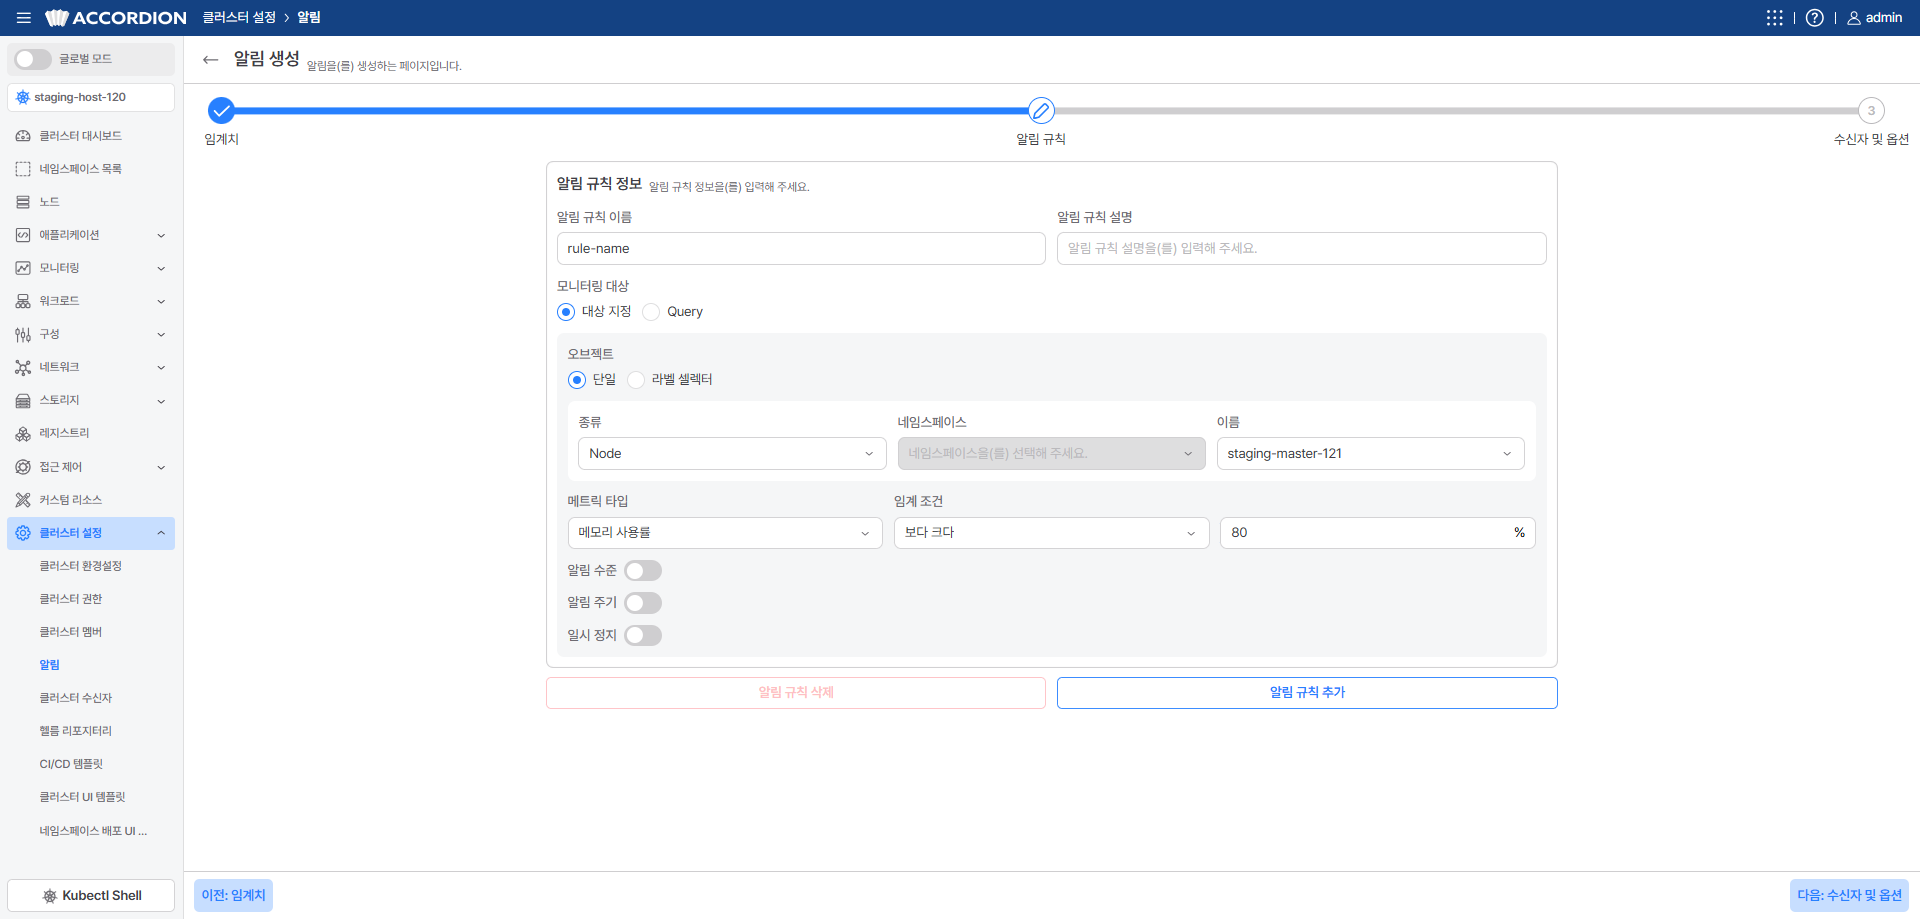
알림 규칙 정보(표)
| 항목 | 설명 |
|---|---|
| 알림 규칙 이름 | 알림 규칙 이름 |
| 알림 규칙 설명 | 알림 규칙에 대한 설명 |
| 모니터링 대상 | 대상 지정 혹은 Query (Prometheus Query) |
| 알림 수준 | 알림 경보 수준 |
| 알림 주기 | 알림 발송을 위한 시간을 설정 • 그룹 대기 시간: 처음 알림이 대기하는 시간 • 그룹 반복 시간: 알림 발송 후 재발송되기까지 대기 시간 • 알람 반복 시간: 알림 재발송 시간 간격 |
| 일시 정지 | 시작일자 혹은 스케줄 을 기준으로 지속 시간 만큼 알림 발송을 제한한다. • 지속 시간은 1d, 2h30m, 45m, 30s 등의 형식으로 입력할 수 있다. (d: 일, h: 시간, m: 분, s: 초) |
- 알림 종류가
이상탐지및장애예측의 경우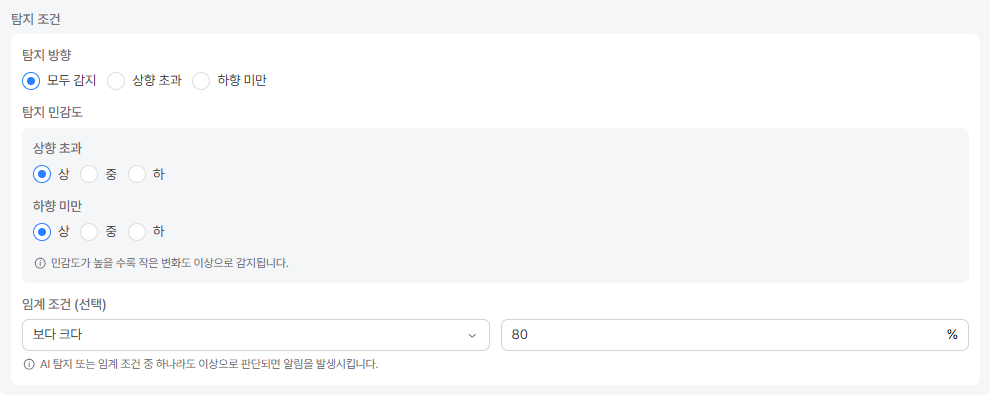
| 항목 | 설명 |
|---|---|
| 탐지 방향 | 이상탐지 및 장애예측에 대해서 탐지할 방향 • 모두 감지 : 정상 범위를 기준으로 증가 및 감소인 경우를 이상으로 모두 감지 • 상향 초과 : 정상 범위의 상한값을 초과하여 증가하는 경우를 이상으로 감지 • 하향 미만 : 정상 범위의 하한값 미만으로 감소하는 경우를 이상으로 감지 |
| 탐지 민감도 | 상 , 중 , 하 중 선택하며, 민감도가 높을수록 정상 범위의 경계가 좁아져 작은 변화도 이상으로 감지한다. • 상 : 정상 범위 경계를 좁게 설정하여 작은 변동에도 이상을 감지한다. (단, 오탐이 증가할 수 있다.) • 중 : 일반적인 모니터링에 적합한 수준이다. • 하 : 정상 범위 경계를 넓게 설정하여 큰 변동만 이상으로 감지한다. |
| 임계 조건(선택) | 알고리즘과 임계 조건을 함께 적용하여, 두 조건 모두 이상치로 판단될 경우에만 이상치로 감지한다. • 임계 조건 : 보다 크다(>), 크거나 같다(>=), 보다 작다(<), 작거나 같다(<=) • 설정값 : 실수 형태의 값 |
- 알림 대상이
대상 지정의 경우
| 항목 | 설명 |
|---|---|
| 오브젝트 | 단일 혹은 라벨 셀렉터 선택 |
| 종류 | 노드 혹은 워크로드(디플로이먼트, 스테이트풀셋, 데몬셋, 잡, 크론잡, 파드) 중 선택 |
| 네임스페이스 | 네임스페이스 선택 |
| 이름 | 오브젝트가 단일 의 경우 리소스 이름 선택 |
| 라벨 셀렉터 | 오브젝트가 라벨 셀렉터 의 경우 라벨 셀렉터 설정 (복수 라벨 가능) • 키: 매칭 할 라벨 키 값 • 밸류: 매칭 할 라벨 밸류 값 |
| 메트릭 타입 | 노드 메트릭 타입 • CPU 사용률 • 메모리 사용률 • 디스크 사용률 워크로드 메트릭 타입 • CPU 사용률 • 메모리 사용률 • 액티브 서비스 • 응답시간 • Gc 시간 |
| 임계 조건 | • 일치 • 불일치 • 보다 크다 • 크거나 같다 • 보다 작다 • 작거나 같다 |
| 임계 조건 설정값 | % (Percent) • CPU 사용률 • 메모리 사용률 • 디스크 사용률 개수 (Count) • 액티브 서비스 초 (Second) • 응답시간 • Gc 시간 |
- 알림 대상이
Query의 경우
| 항목 | 설명 |
|---|---|
| Query | Prometheus Query 입력 |
| 임계 조건 | • 일치 • 불일치 • 보다 크다 • 크거나 같다 • 보다 작다 • 작거나 같다 |
| 임계 조건 설정값 | 임계 조건의 값에 해당하는 query 혹은 숫자 입력 |
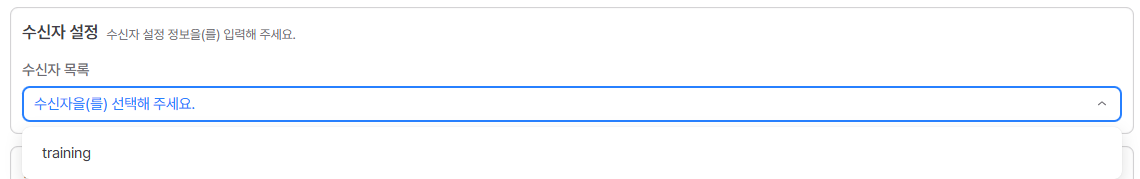
알림 수신자 설정 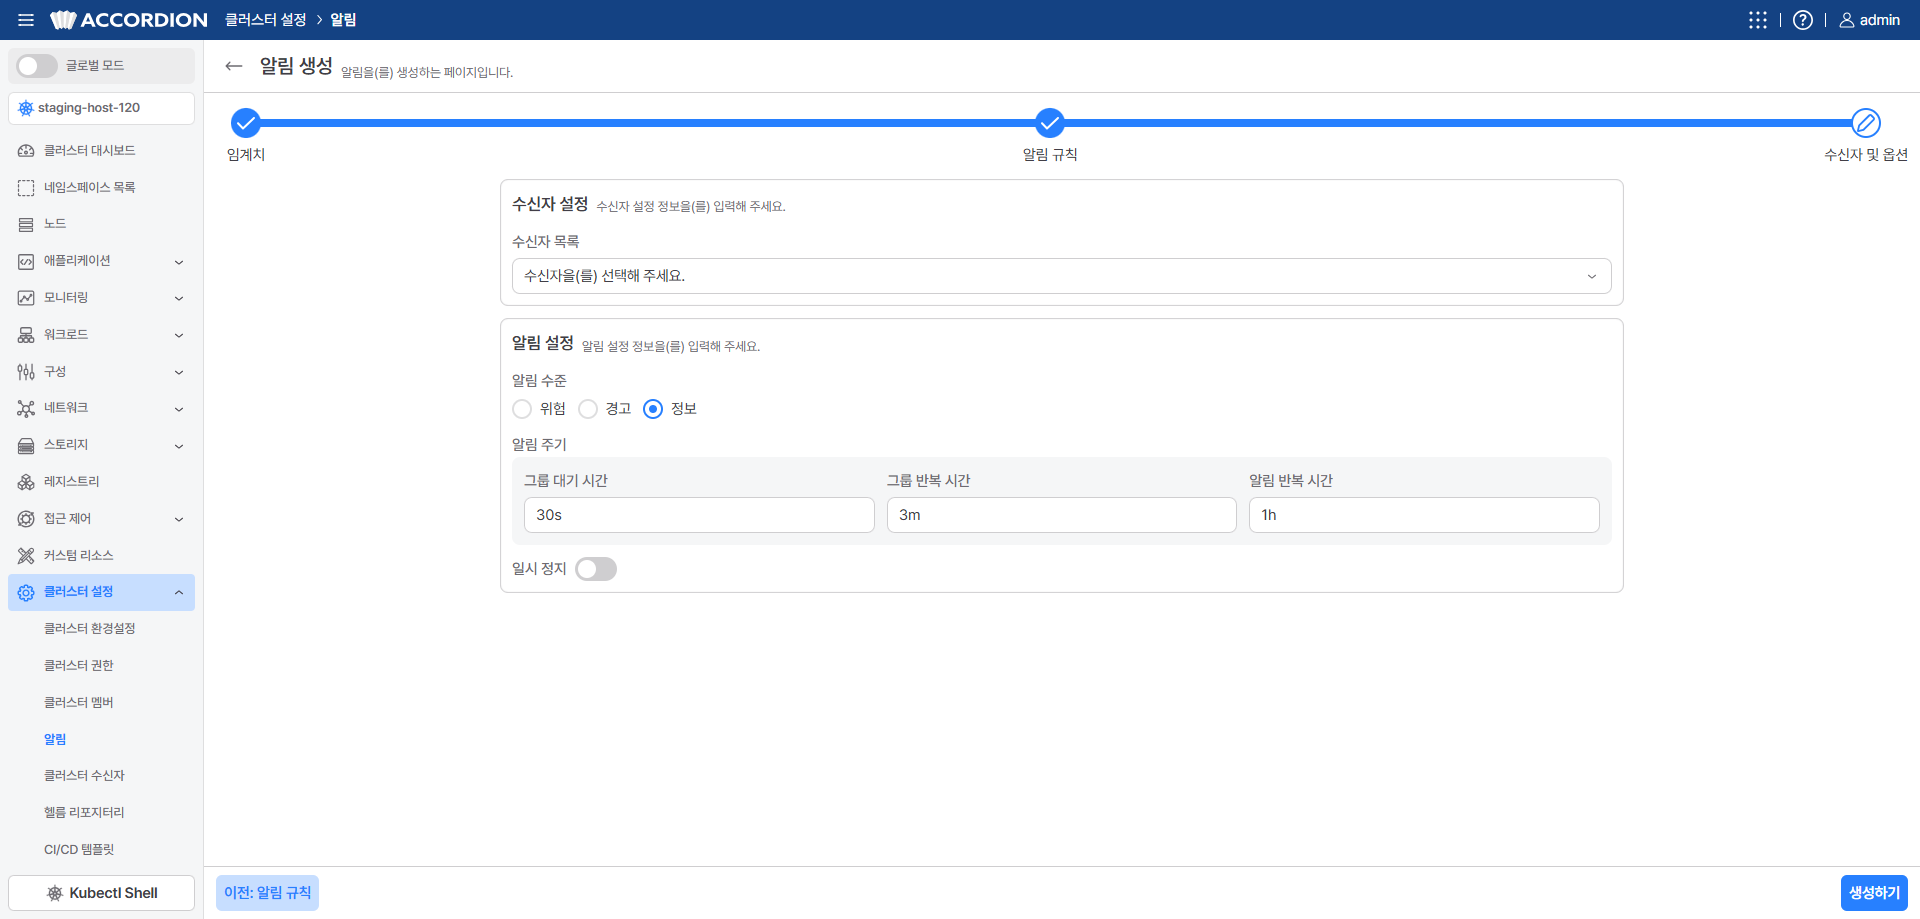 수신자 설정
알림 설정 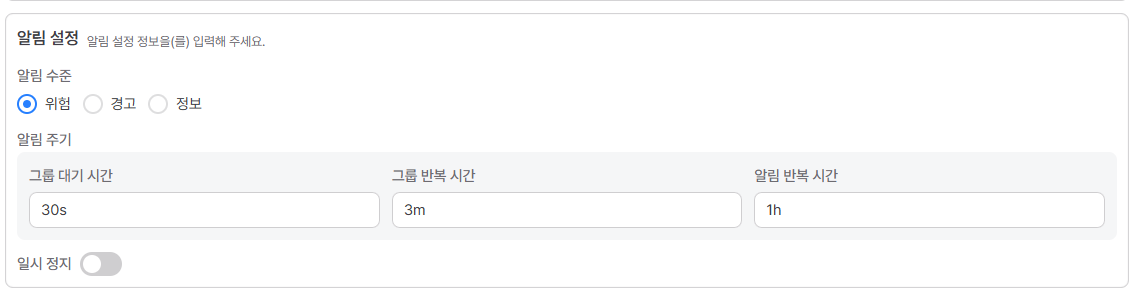
알림 설정(표)
| 항목 | 설명 |
|---|---|
| 수신자 목록 | 알림을 받을 클러스터 수신자 목록 (클러스터 수신자 메뉴에서 생성) |
| 알림 수준 | 알림 경보 수준 |
| 알림 주기 | 모니터링 기간 내 이상 감지 횟수 기준에 따라 알림을 발송하도록 설정 • 그룹 대기 시간: 처음 알림이 대기하는 시간 • 그룹 반복 시간: 알림 발송 후 재발송되기까지 대기 시간 • 알람 반복 시간: 알림 재발송 시간 간격 |
| 일시 정지 | 시작일자 혹은 스케줄 을 기준으로 지속 시간 만큼 알림 발송을 제한한다. • 지속 시간은 1d, 2h30m, 45m, 30s 등의 형식으로 입력할 수 있다. (d: 일, h: 시간, m: 분, s: 초) |
- 알림 종류가
이상탐지및장애예측의 경우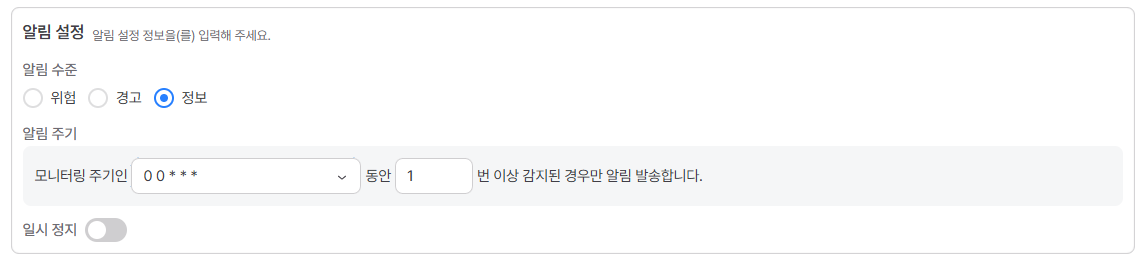
상세 옵션
알림 종류가 이상탐지 및 장애예측 의 경우에만 설정할 수 있습니다. 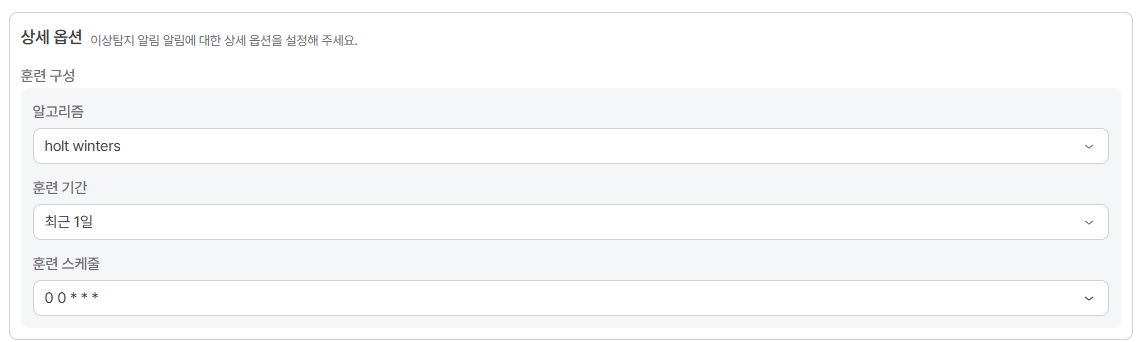
상세 옵션(표)
| 항목 | 설명 |
|---|---|
| 알고리즘 | 시스템의 데이터 패턴은 서비스 특성에 따라 다양하게 나타난다. 각 알고리즘의 동작 원리와 적합한 활용 사례를 파악하여 최적의 탐지 모델을 구성할 수 있다. • holt winters: 데이터의 추세와 계절성(반복 주기)을 동시에 분석하여 주기적 패턴을 가진 지표의 이상징후를 탐지함. • isolation forest: 전체 데이터 분포에서 비정상적으로 고립된 수치를 분리하여 산발적으로 발생하는 이상징후를 식별함. • oneclass svm: 정상 데이터의 경계 영역을 학습하고 이를 벗어나는 예측 불가능한 이상징후를 감시함. • moving average: 일정 기간의 평균치 대비 변동 폭을 분석하여 단기적인 급격한 지표 변화를 즉각 탐지함. • sgd classifier: 학습된 정상/이상 상태의 특징값을 기반으로 유입되는 데이터를 실시간으로 신속히 분류함. • prophet: 휴일이나 복합적 계절성 등 다양한 변수를 자동으로 반영하여 시계열 데이터의 장기적 흐름을 예측함. 🔔 NOTE 장애예측 알림의 경우 holt winters 알고리즘만 지원된다. |
| 훈련 기간 | 모델을 학습에 사용하는 과거 데이터 범위를 설정한다. 최근 N일 또는 사용자 지정 중 선택할 수 있다. 최소 60분 이상의 데이터가 필요하며, 데이터가 부족한 경우 훈련이 수행되지 않는다. |
| 훈련 스케줄 | 모델을 자동으로 재학습하는 주기 및 스케줄을 Cron 형태로 설정한다. |
알림 정책 수정
수정하려는 알림 정책을 선택하고 우측의 수정 버튼을 선택합니다. 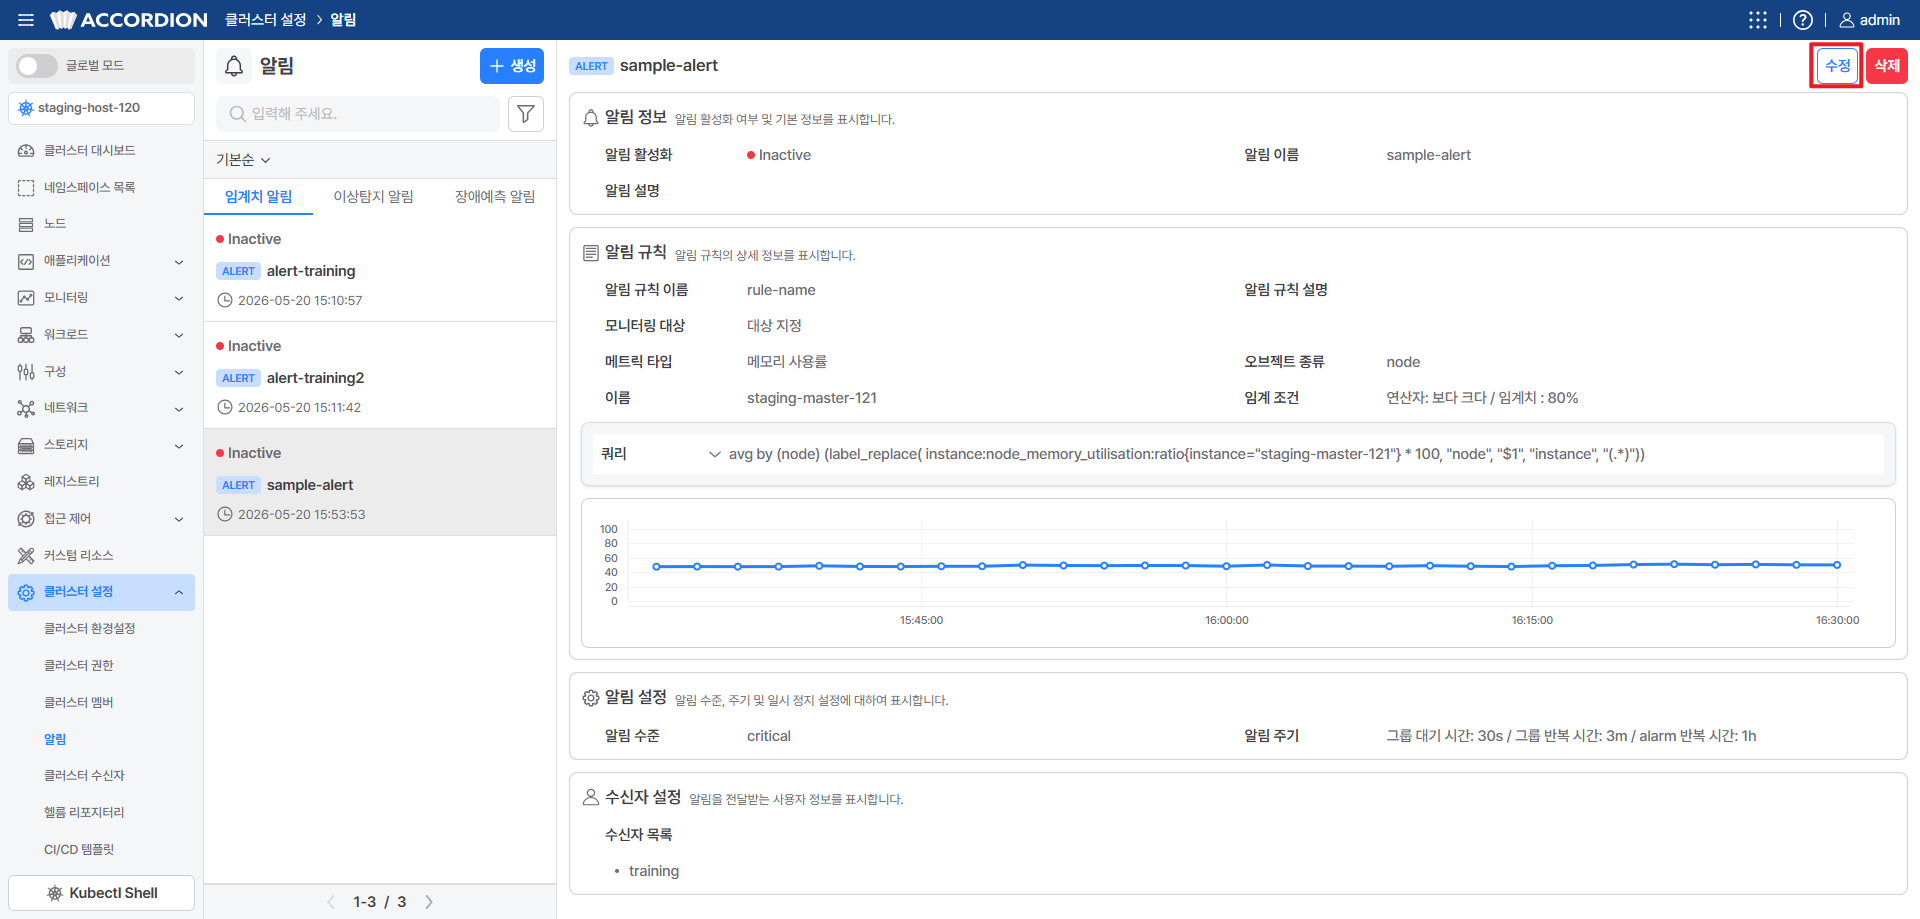
알림 정책 삭제
삭제하려는 알림 정책을 선택하고 우측의 삭제 버튼을 선택합니다.
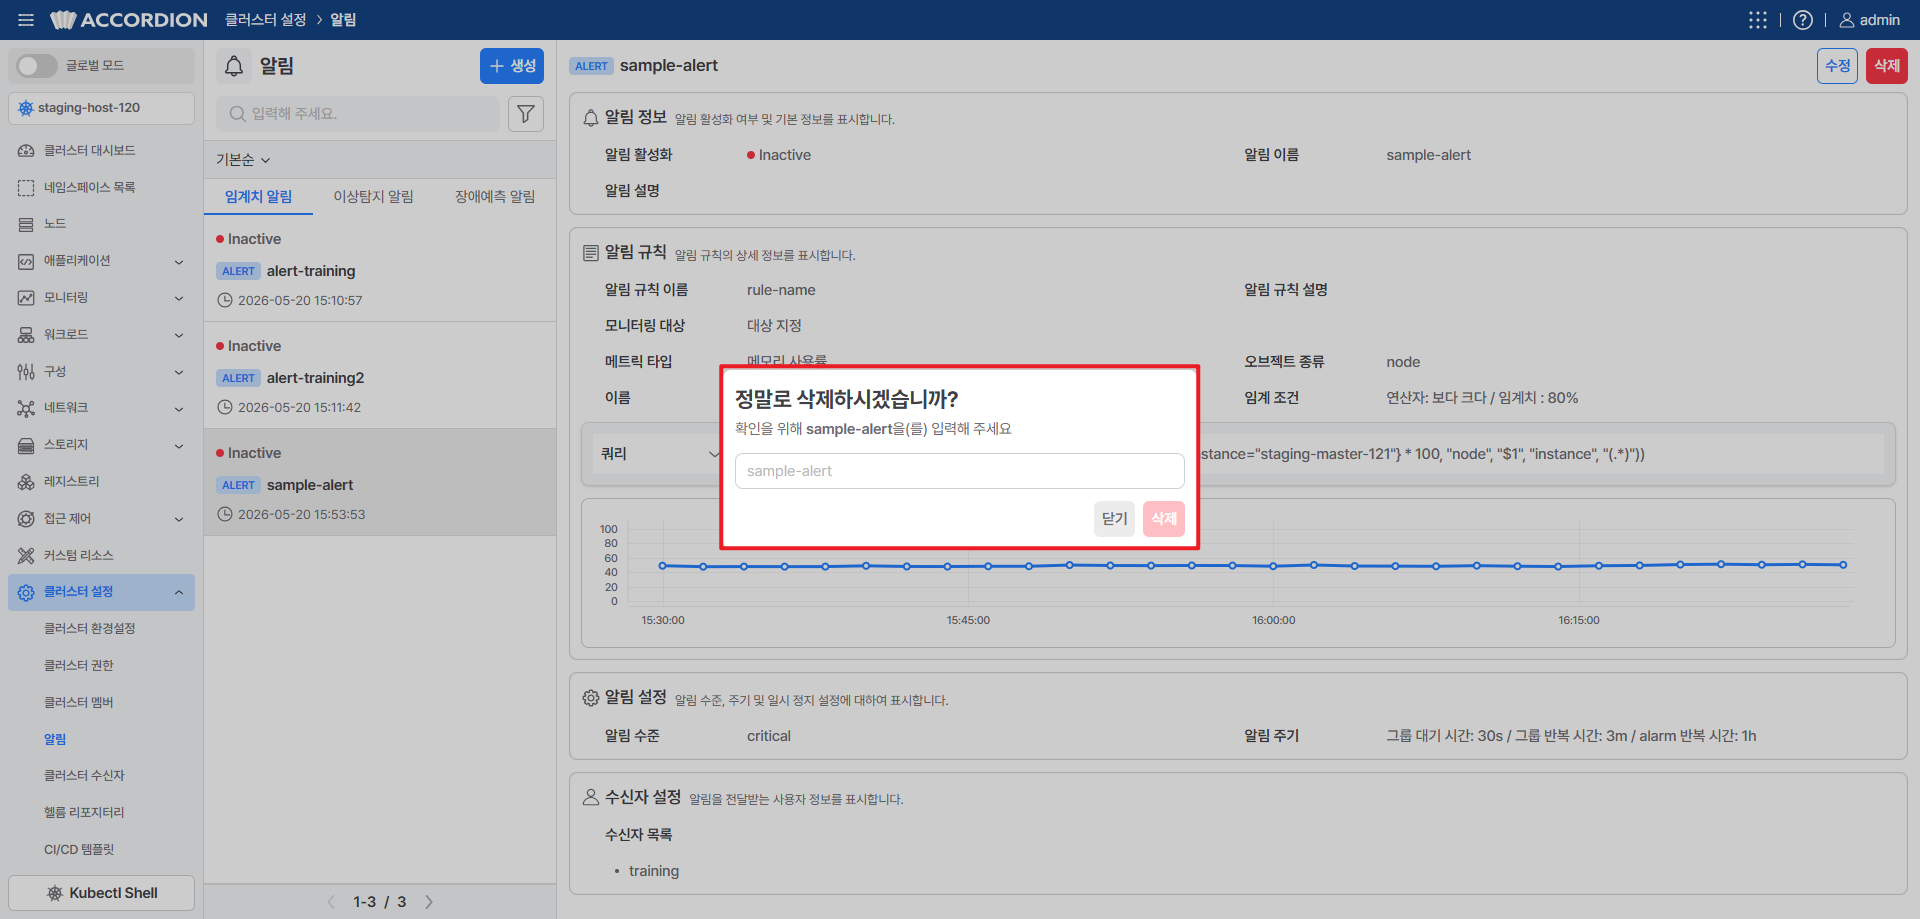
모달에서 알림 정책 이름을 입력하여 삭제합니다.