클러스터
Table of contents
- 실습1: 클러스터 범위 알림 정책 설정
- 1) 타입 : 노드(Node)
- 2) 타입 : 노드 셀렉터(Node Selector)
- 3) 타입 : 표현식(Expression)
- 노드 관련 PromQL 리소스 메트릭 예시
Cluster
실습1: 클러스터 범위 알림 정책 설정
사용자는 워커노드에 리소스 사용률에 대해 알림을 받을 수 있습니다.
사용자는 설정 한 노드에서 임계치가 넘었을 시점으로부터 대기 시간 이후에 몇 분(시간) 간격으로 반복적으로 알림을 받고 이 알림 반복설정을 하여 사용자가 설정한 이메일 or 슬랙 채널로 알림을 발송 받을 수 있습니다. 또한 알림을 원하지 않을 경우 알림 시간 제한으로 시간대를 설정 할 수 있습니다.
실습용 슬랙 정보
- Webhook URL : https://hooks.slack.com/services/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
- Channel : #alram-accordion
1) 타입 : 노드(Node)
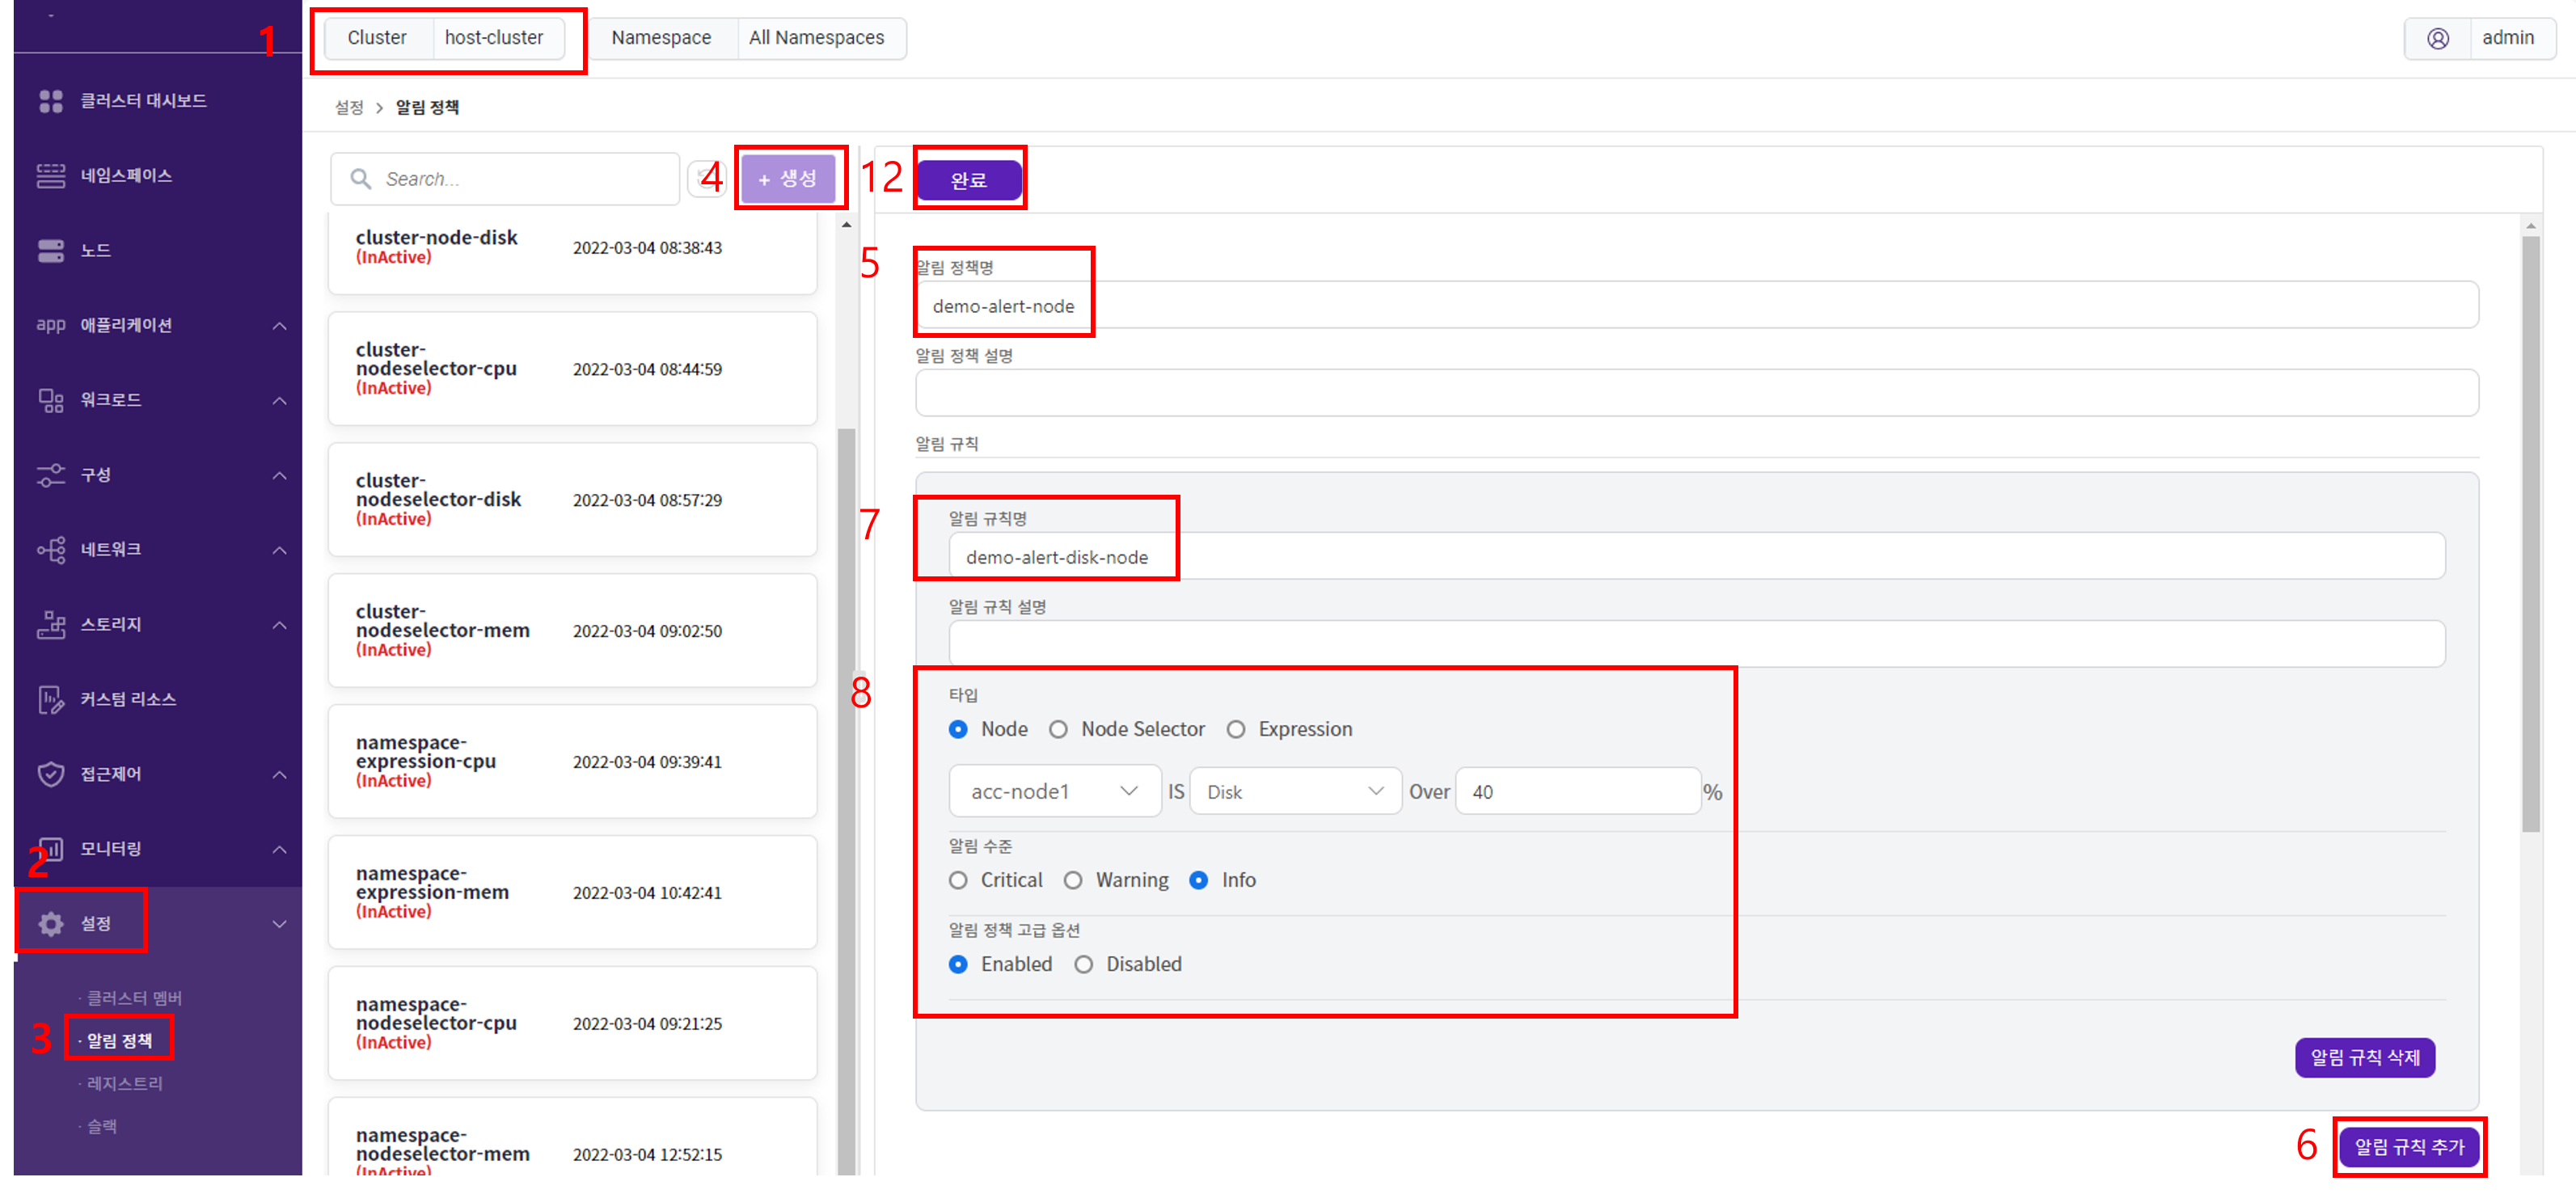
- 알림을 받고자 하는 클러스터 노드 선택
- 설정 메뉴 선택
- 알림 정책 선택
- 알림 정책 생성
- 알림 정책명: demo-alert-node 작성
- 알림 규칙 추가
- 알림 규칙명: demo-alert-disk-node 작성
- 타입을 Node로 지정 acc-node1에서 disk 사용률이 40% 이상일 시 알림 수준을 Info 수준으로 메일 or 슬랙으로 알림 발송, 알림 발송 시간에 대한 설정은 알림 정책 고급옵션 활성화
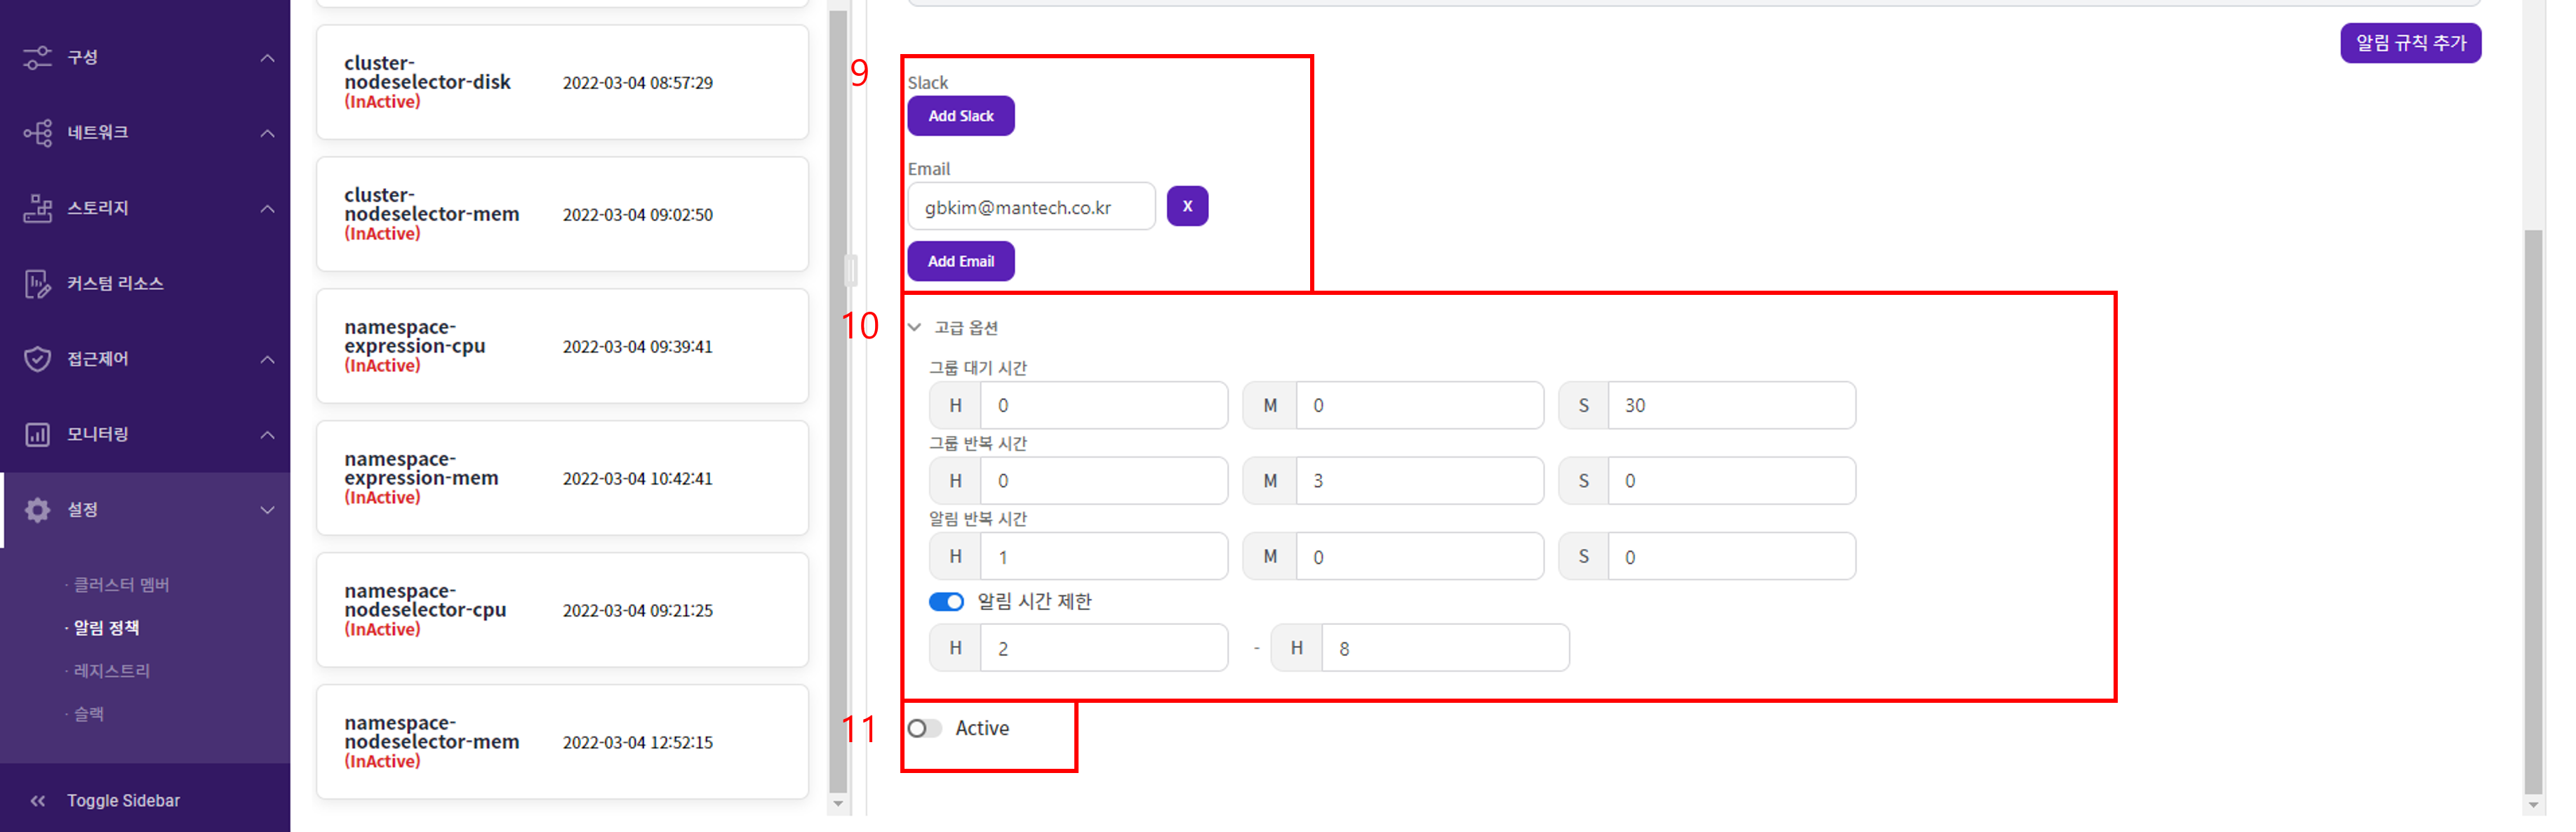
- 발송 받을 슬랙 및 메일 추가,설정
처음 알림 오기까지 30초 대기(그룹 대기 시간) 후 3분 간격으로 반복 알림(그룹 반복 시간) 후 1시간 후에 다시 알림 발송(알림 반복 시간) 설정, 알림 발송 제한은 am 02 ~ am 08 시로 설정 (즉, 그룹대기시간: 30초, 그룹 반복 시간: 3분, 알림 반복 시간: 1시간) 처음 알림 대기 시간 30초 이후 1시간 3분 간격으로 알림 발송
- 알림 규칙 활성화
- 알림 규칙 설정 완료
2) 타입 : 노드 셀렉터(Node Selector)
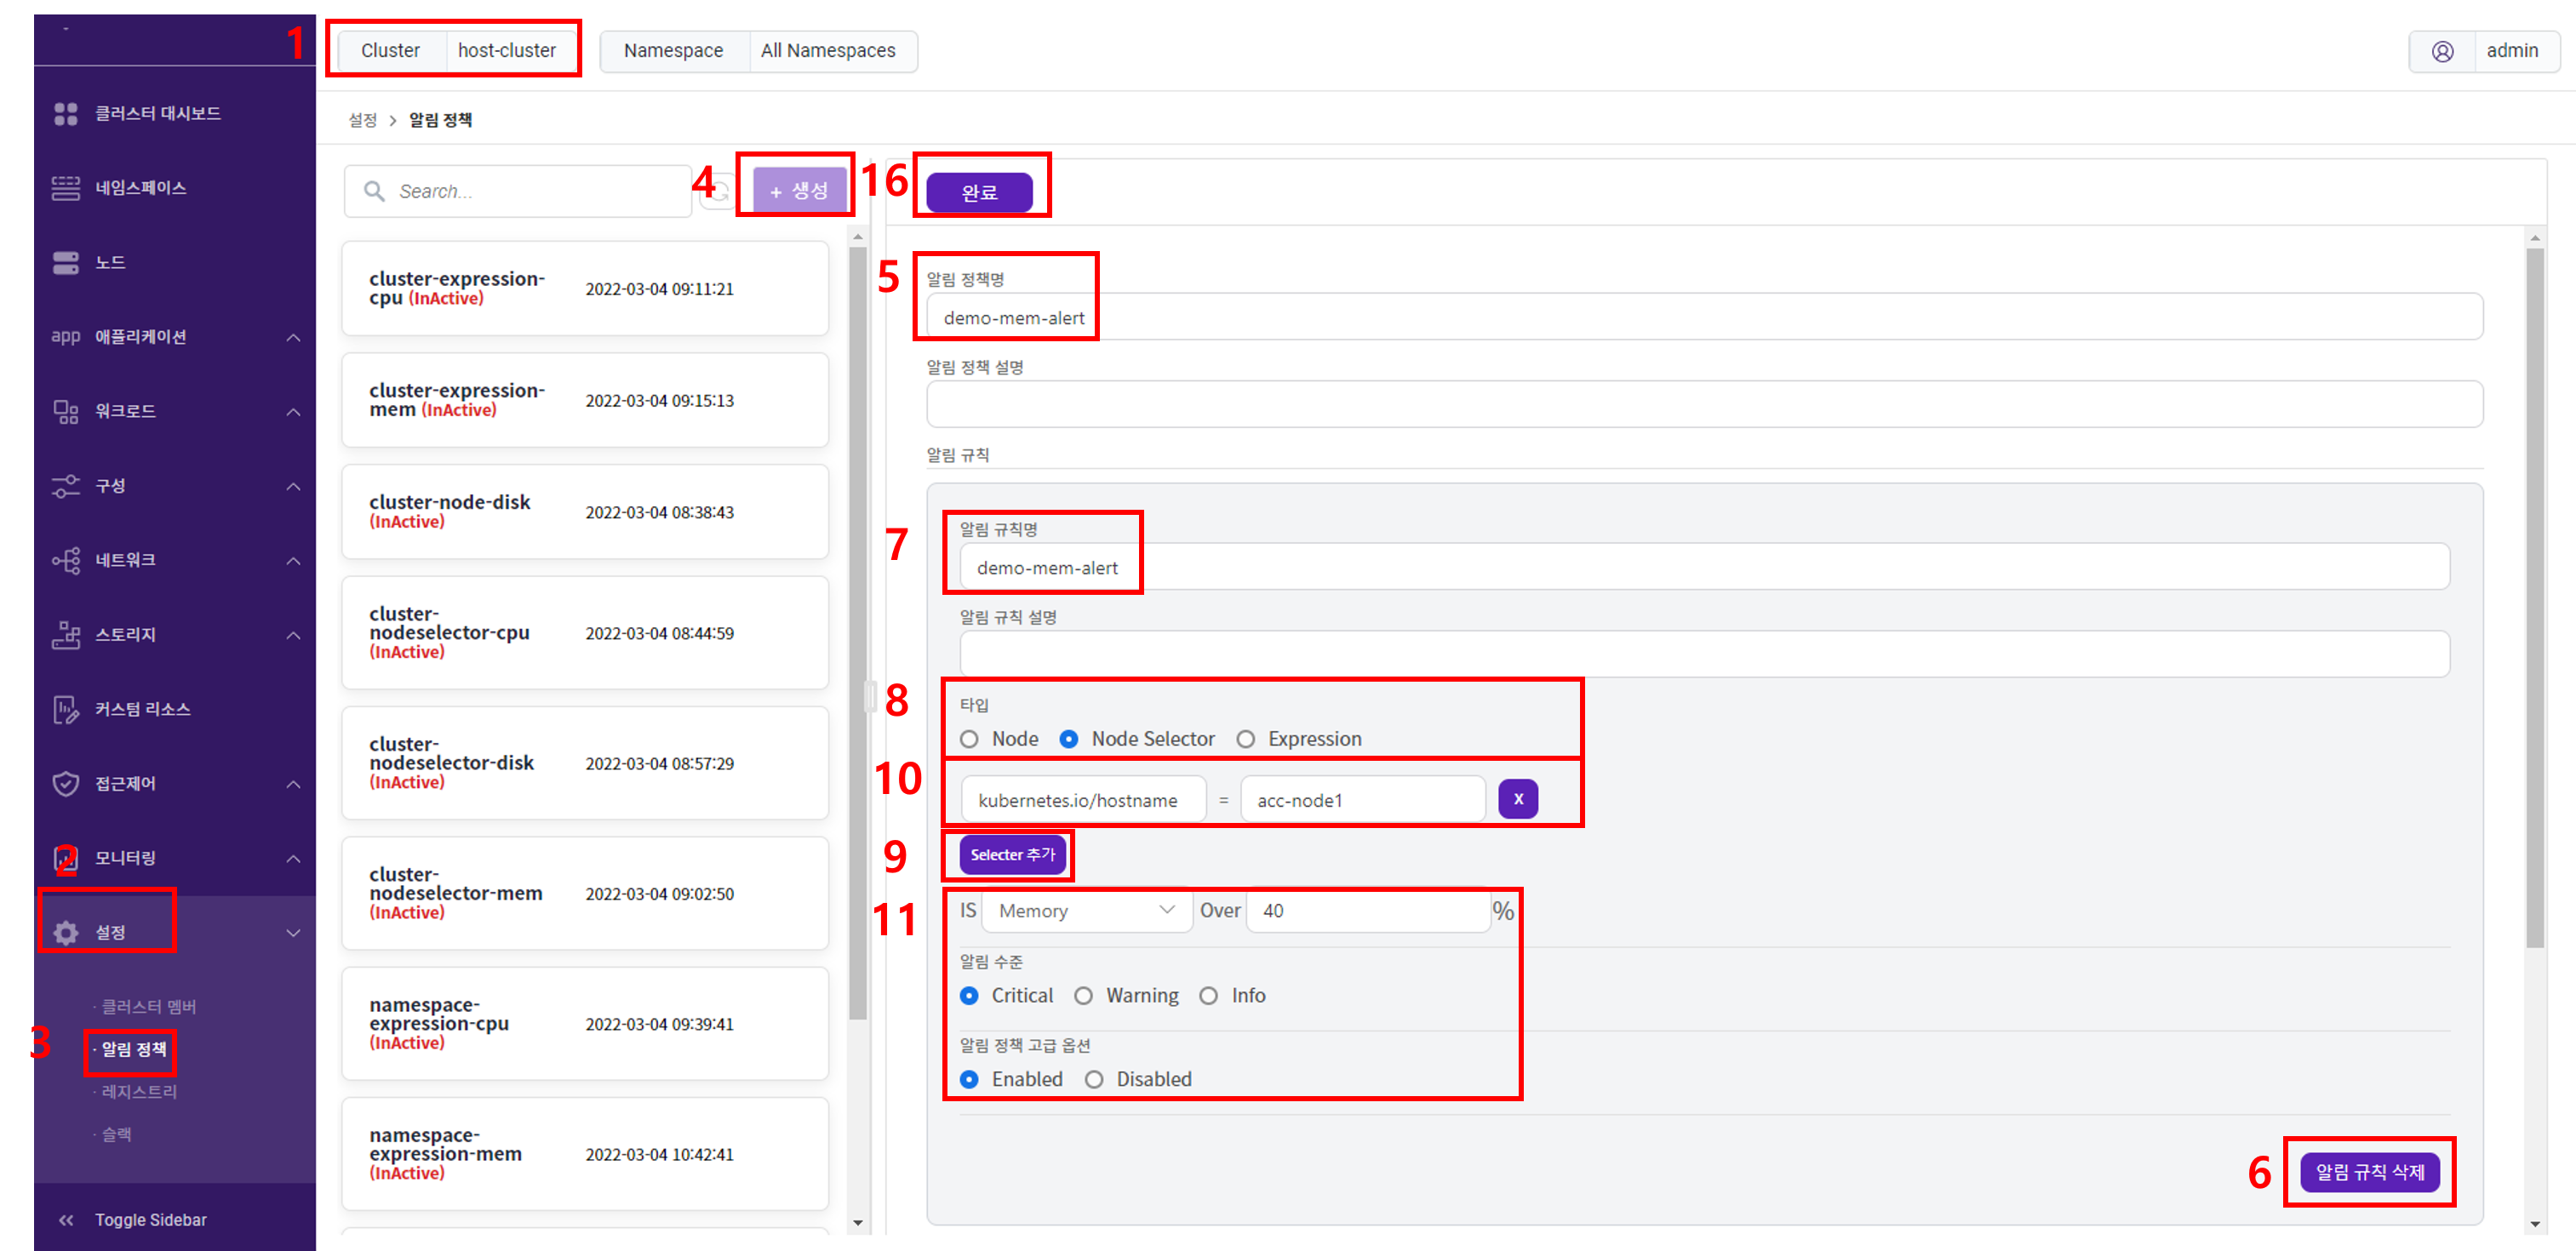
- 알림을 받고자 하는 클러스터 노드 선택
- 설정 메뉴 선택
- 알림 정책 선택
- 알림 정책 생성
- 알림 정책명: demo-mem-alert 작성
- 알림 규칙 추가
- 알림 규칙명: demo-mem-alert 작성
- 타입: Node Selector
- Node Selector 추가
- kubernetes.io/hostname=acc-node1 작성
- kubernetes.io/hostname=acc-node1 설정이 있는 deploy에서 memory 사용률이 40% 이상일 시 알림 수준을 Critical 수준으로 메일 or 슬랙으로 알림 발송
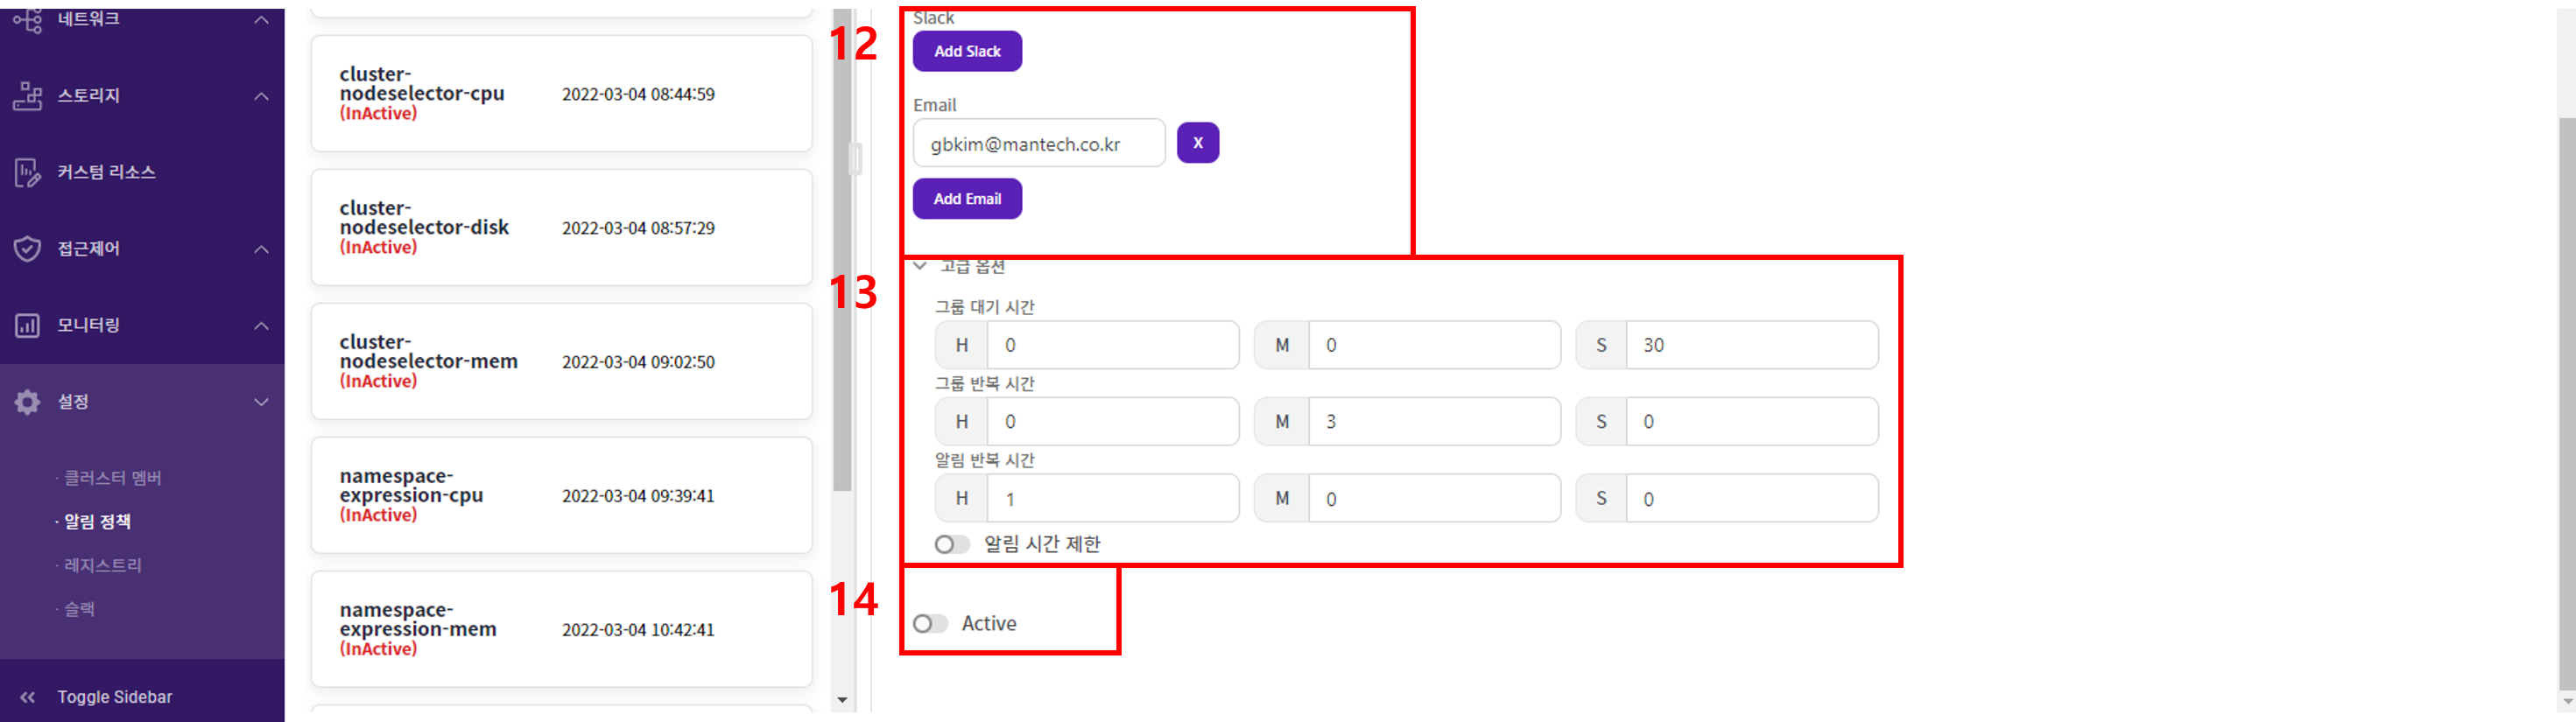
- 발송 받을 슬랙 및 메일 추가,설정
- 알림 발송 시간에 대한 설정은 알림 정책 고급옵션 비활성화로 처음 알림 오기까지 30초 대기(그룹 대기 시간) 후 3분 간격으로 반복 알림(그룹 반복 시간) 후 1시간 후에 다시 알림 발송(알림 반복 시간) 설정, 알림 발송 제한은 am 02 ~ am 08 시로 설정
- 알림 설정에 대한 활성화
- 알림 정책 설정 완료
3) 타입 : 표현식(Expression)
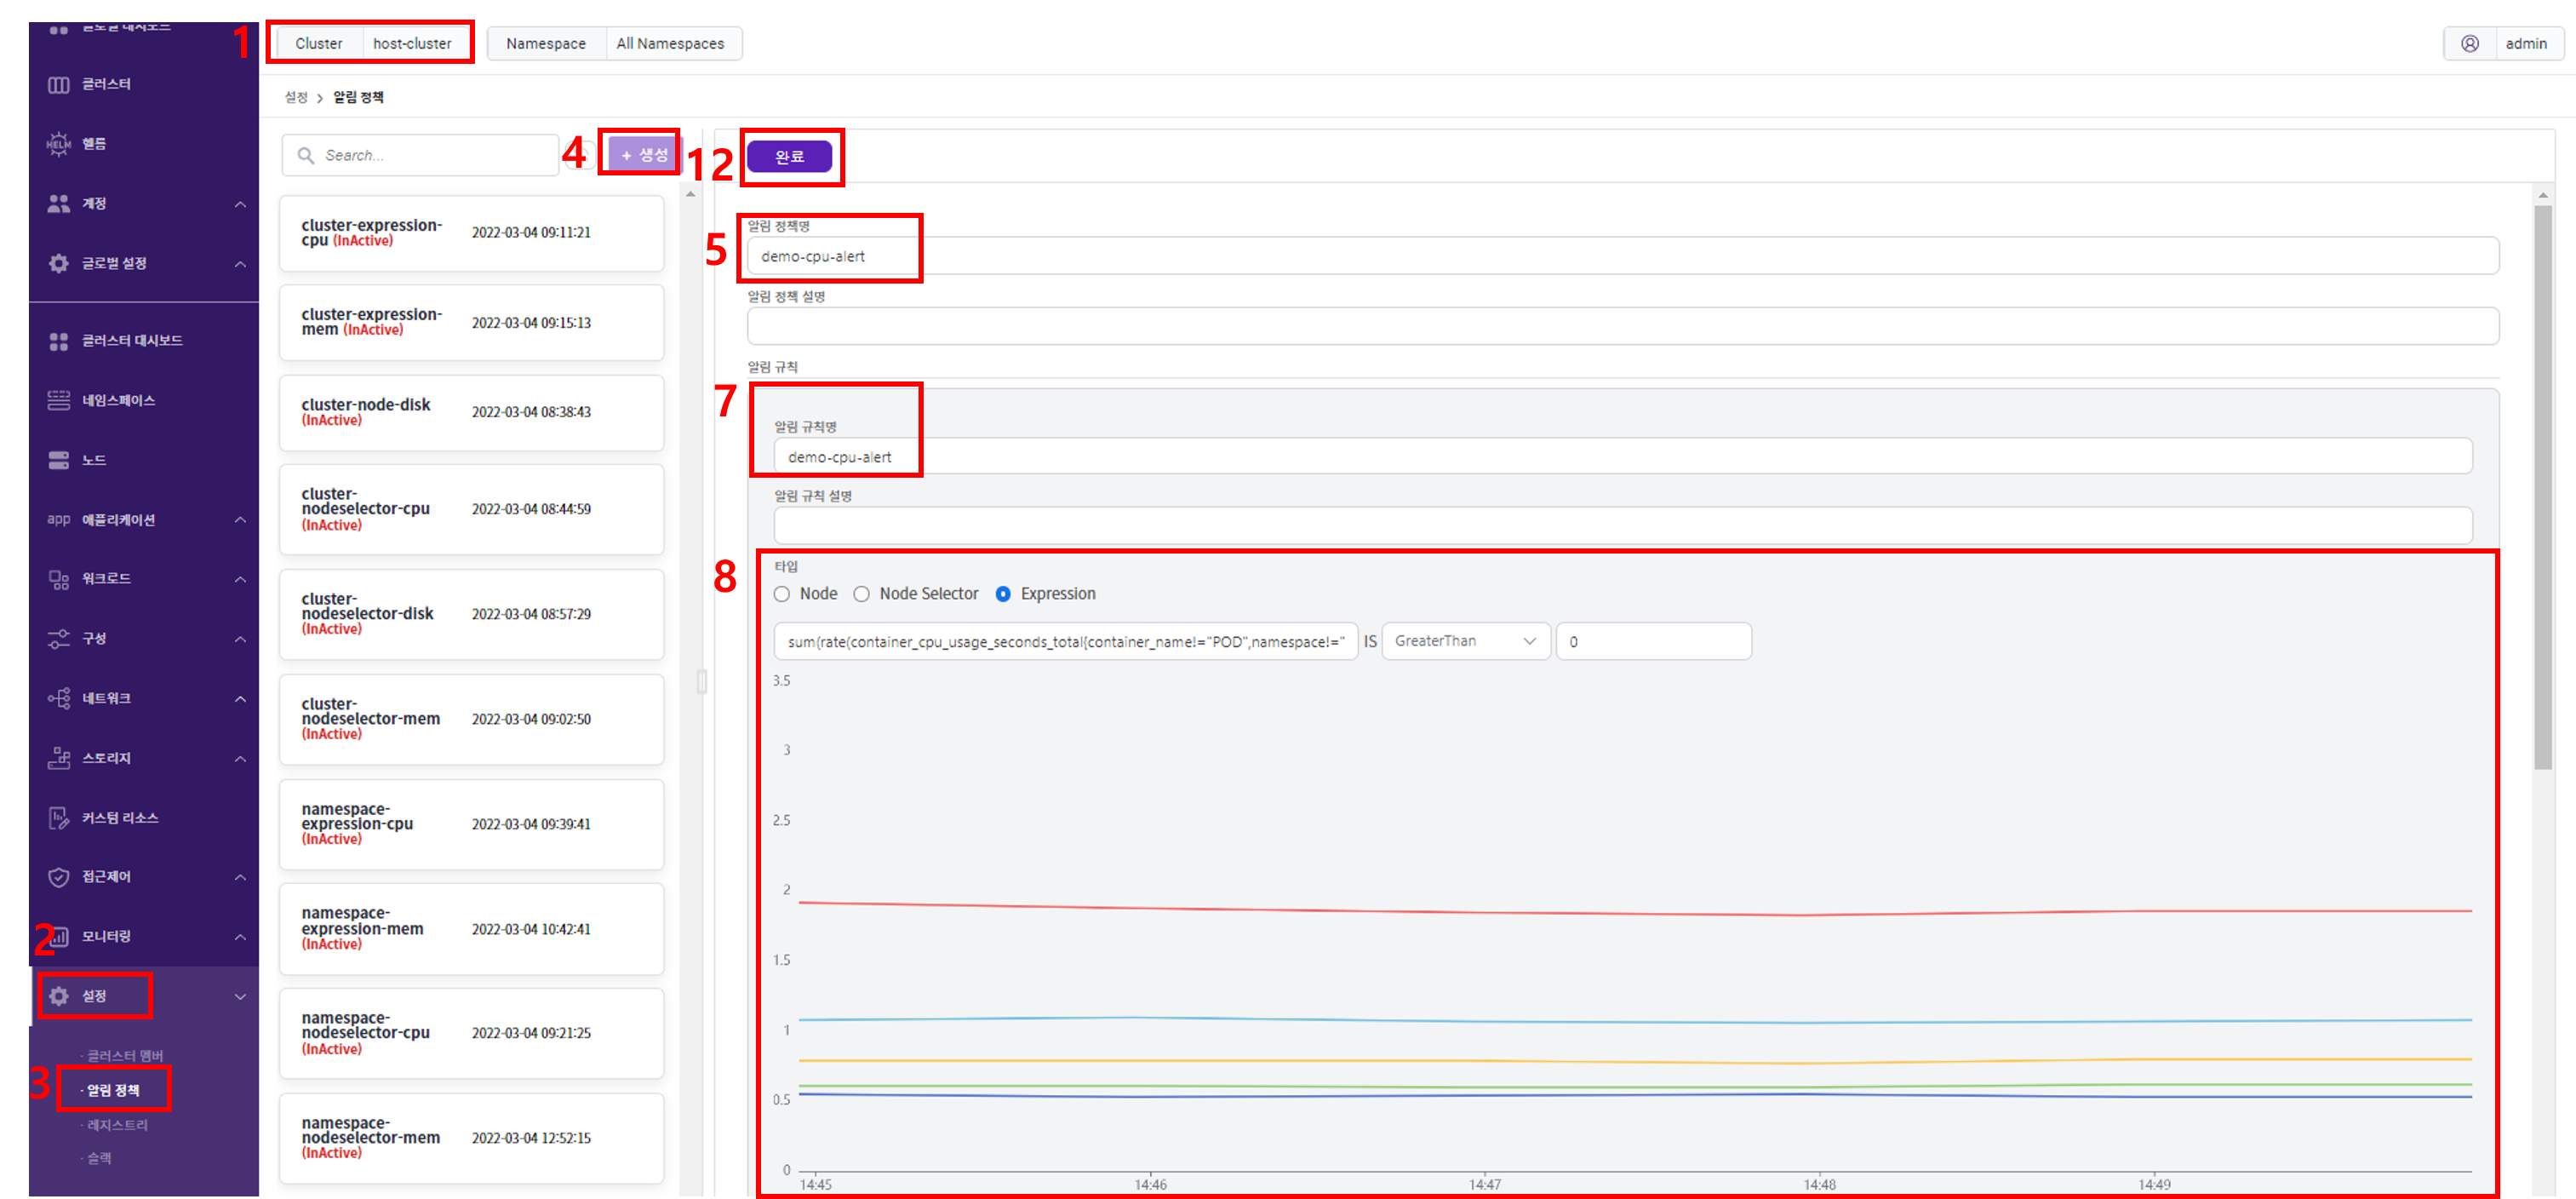
- 알림을 받고자 하는 클러스터 노드 선택
- 설정 메뉴 선택
- 알림 정책 선택
- 알림 정책 생성
- 알림 정책명: demo-cpu-alert 작성
- 알림 규칙 추가
- 알림 규칙명: test-cpu-alert 작성
- 타입을 Expresstion으로 지정 클러스터 node에 대한 CPU 사용량이 이상일 시 알림 수준을 critical 수준으로 메일 or 슬랙으로 알림 발송, 알림 발송 시간에 대한 설정은 알림 정책 고급옵션 활성화 EX) sum(rate(container_cpu_usage_seconds_total{container_name!=”POD”,namespace!=””}[5m])) by (node)
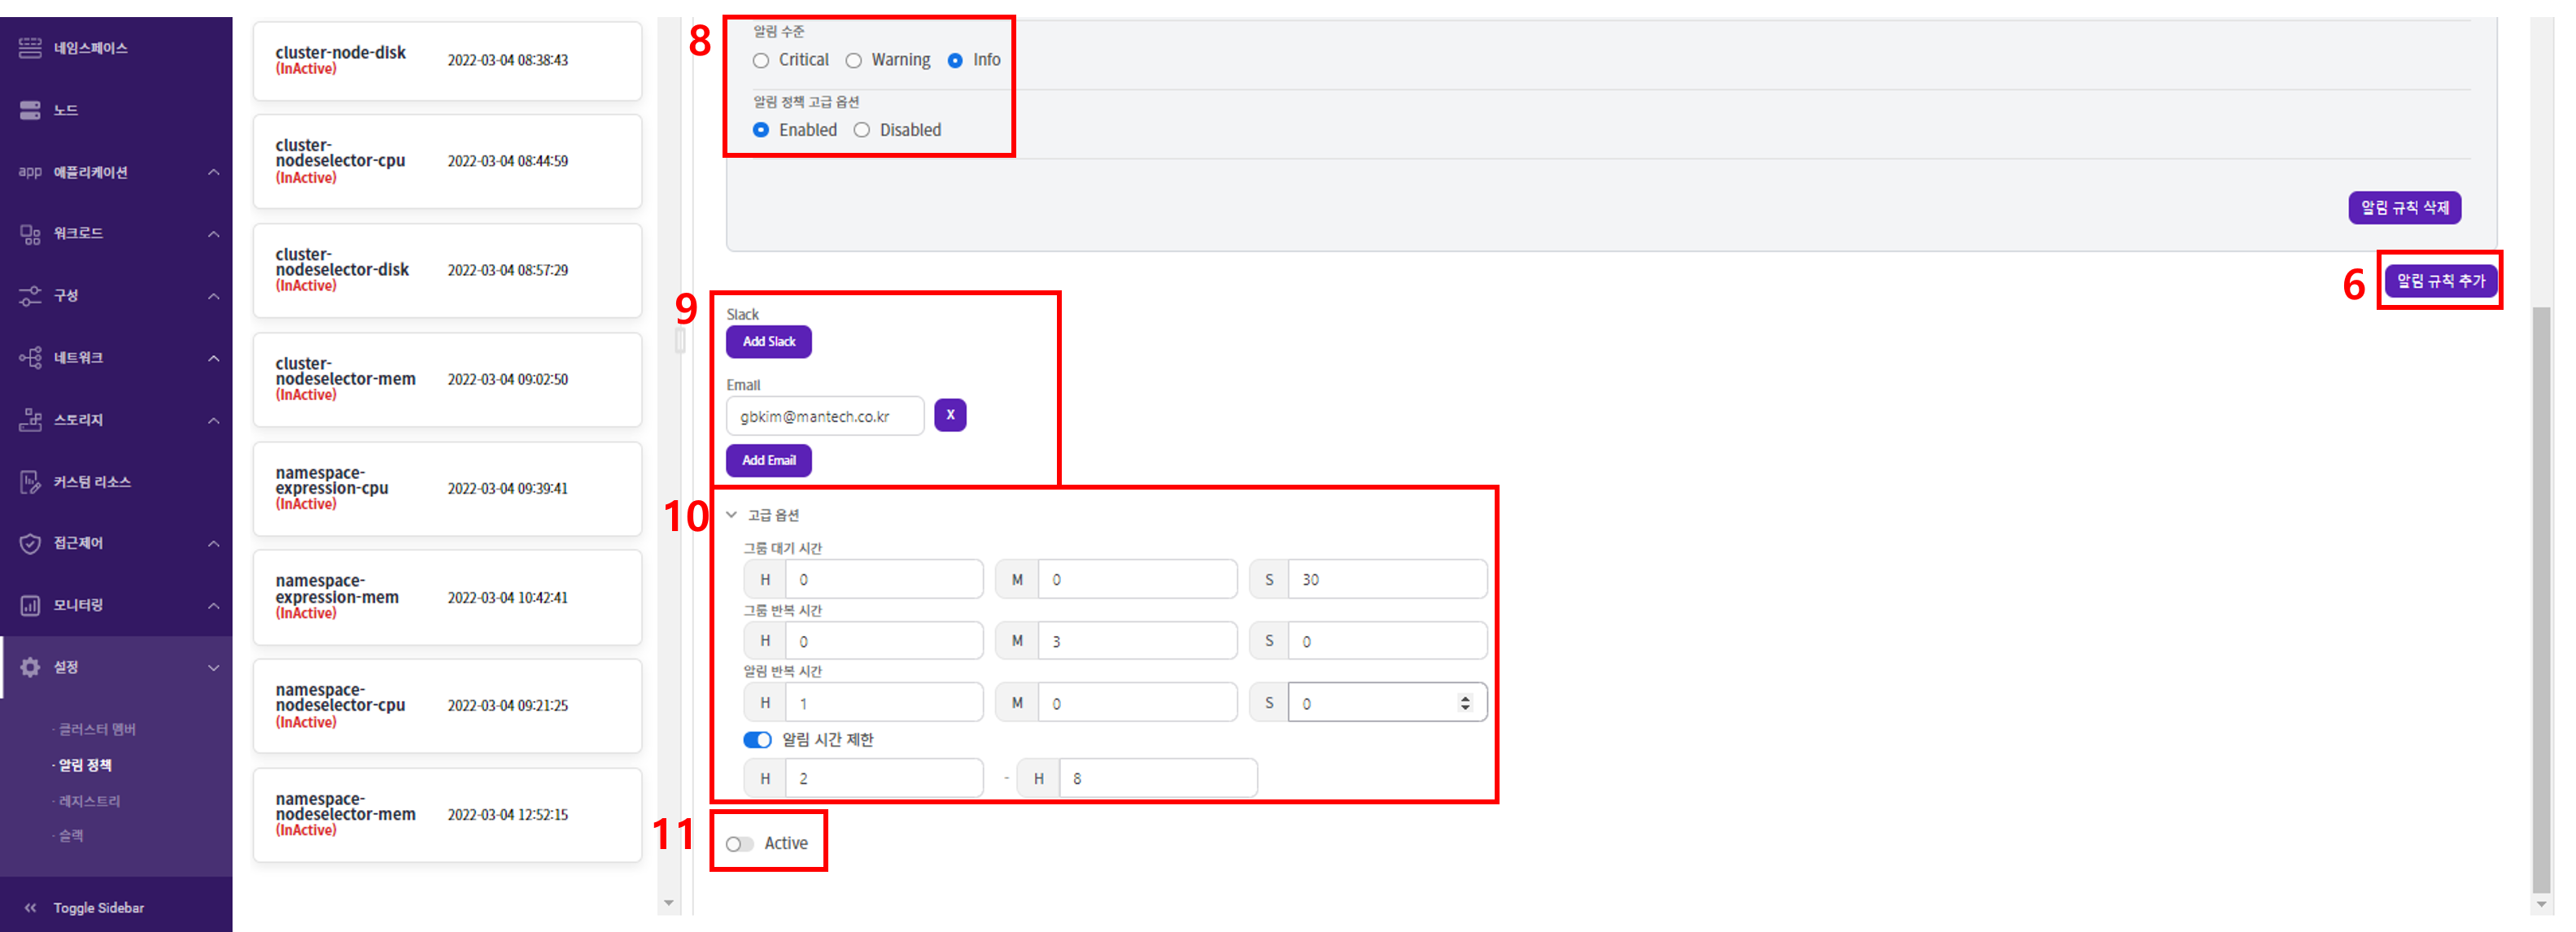
- 발송 받을 슬랙 및 메일 추가,설정
- 처음 알림 오기까지 30초 대기(그룹 대기 시간) 후 3분 간격으로 반복 알림(그룹 반복 시간) 후 1시간 후에 다시 알림 발송(알림 반복 시간) 설정, 알림 발송 제한은 am 03 ~ am 08 시로 설정
- 알림 규칙 활성화
- 알림 규칙 설정 완료
노드 관련 PromQL 리소스 메트릭 예시
메트릭 예시
# Resource Metric: Kubernetes 컨테이너 CPU 사용량

container_cpu_usage_seconds_total
sum(rate(container_cpu_usage_seconds_total{container_name!="POD",namespace!=""}[5m])) by (node)

# Resource Metric: Kubernetes 네임스페이스 CPU 사용량

sum(rate(container_cpu_usage_seconds_total{container_name!="POD",namespace!=""}[5m])) by (namespace)

# Resource Metric: Kubernetes CPU 요청

sum(kube_pod_container_resource_requests_cpu_cores)

# Resource Metric: Kubernetes Pod CPU 요청

sum(kube_pod_container_resource_requests_cpu_cores) by (pod)

# Resource Metric: Kubernetes 네임스페이스 CPU 요청

sum(kube_pod_container_resource_requests_cpu_cores) by (namespace)

# Resource Metric: Kubernetes CPU 제한

sum(kube_pod_container_resource_limits_cpu_cores)

# Resource metric: Kubernetes 네임스페이스 CPU 제한

sum(kube_pod_container_resource_limits_cpu_cores) by (namespace)

# Resource Metric: Kubernetes 메모리 사용량

sum(kube_pod_container_resource_requests_memory_bytes)

# Resource Metric: Kubernetes 노드 메모리 사용량

sum(kube_pod_container_resource_requests_memory_bytes) by (node)

# Resource Metric: Kubernetes 메모리 요청

sum(kube_pod_container_resource_limits_memory_bytes)

# Resource Metric: Kubernetes 노드 메모리 요청

sum(kube_pod_container_resource_limits_memory_bytes) by (node)

# 클러스터 및 네임스페이스당 포드 수 확인

sum by (namespace) (kube_pod_info)

# CPU 제한이 없는 클러스터 및 네임스페이스별 컨테이너 수 확인

count by (namespace)(sum by (namespace,pod,container)(kube_pod_container_info{container!=""})
unless sum by (namespace,pod,container)(kube_pod_container_resource_limits{resource="cpu"}))

count by (node)(sum by (namespace,pod,container)(kube_pod_container_info{container!=""})
unless sum by (namespace,pod,container)(kube_pod_container_resource_limits{resource="cpu"}))

# 모든 종류의 문제가 있는 모든 Pod 확인

sum by (namespace) (kube_pod_status_ready{condition="false"})

# CPU 오버 커밋

sum(kube_pod_container_resource_limits{resource="cpu"}) - sum(kube_node_status_capacity_cpu_cores)

# 메모리 오버 커밋 sum(kube_pod_container_resource_limits{resource="memory"}) -

sum(kube_node_status_capacity_memory_bytes)

# 클러스터 별 준비된 노드 수

sum(kube_node_status_condition{condition="Ready", status="true"}==1) by (node)

# 클러스터 별 사용하지 않는 CPU core 확인

sum((rate(container_cpu_usage_seconds_total{container!="POD",container!=""}[30m]) - on (namespace,pod,container)
group_left avg by (namespace,pod,container)(kube_pod_container_resource_requests{resource="cpu"})) * -1 >0 by (node))

# 클러스터 별 사용하지 않는 memory 확인

sum((container_memory_usage_bytes{container!="POD",container!=""} - on (namespace,pod,container)
avg by (namespace,pod,container)(kube_pod_container_resource_requests{resource="memory"})) * -1 >0 ) / (102410241024)

# Ready 상태가 아닌 node 확인

sum(kube_node_status_condition{condition="NotReady",status="true"})

# 클러스터 수준에서 CPU 사용량

sum (rate (container_cpu_usage_seconds_total{image!=""}[1m])) by (node)